Sun'iy intellekt
Qitʼa va Xitoy AI xavfsizligi bo'yicha aloqa mexanizmini muhokama qilmoqda
Qitʼa va Xitoy rasmiylari AI xavfsizligi bilan bog'liq milliy xavfsizlik xavflarini bir-biriga bildirish mexanizmini muhokama qilishni boshladilar.
Sun'iy intellekt sohasida kichik, lekin yuqori samarali qaror modellariga talab ortib bormoqda. Kev loyihasi aynan shu ehtiyojga javob berib, Qwen3.5 asosidagi 0.8B, 4B va 9B o'lchamdagi modellarni taqdim etadi. Modelning arxitekturasi Jev loyihasining ochiq manbali tavsifi – GitHub – bilan mos keladi, shuningdek, TypeSafe System One API bilan bir xil interfeysga ega.
Kev modeli Qwen3.5 asosida qurilgan bo'lib, avvalgi Qwen3 versiyasiga nisbatan yaxshilangan aniqlik va tezlikni taklif etadi. Modelning har bir versiyasi bir xil trening ma'lumotlari va sozlamalariga ega, lekin parametrlar soni farq qiladi, bu esa xotira talablari va hisoblash quvvatiga moslashuvchanlikni beradi. 4B va 9B modellar 32 GB RAMli Mac kompyuterida bf16 formatida ishlashga mo'ljallangan, bu esa keng tarqalgan ishlab chiquvchilar uchun qulaylik yaratadi.
Kev ning API-si TypeSafe System One ga mos keladi, shuning uchun foydalanuvchilar Python SDK orqali o'z lokal serverlariga osongina ulanadilar. Quyidagi kod namunasida Kev‑4B modelini ishga tushirish ko'rsatilgan:
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
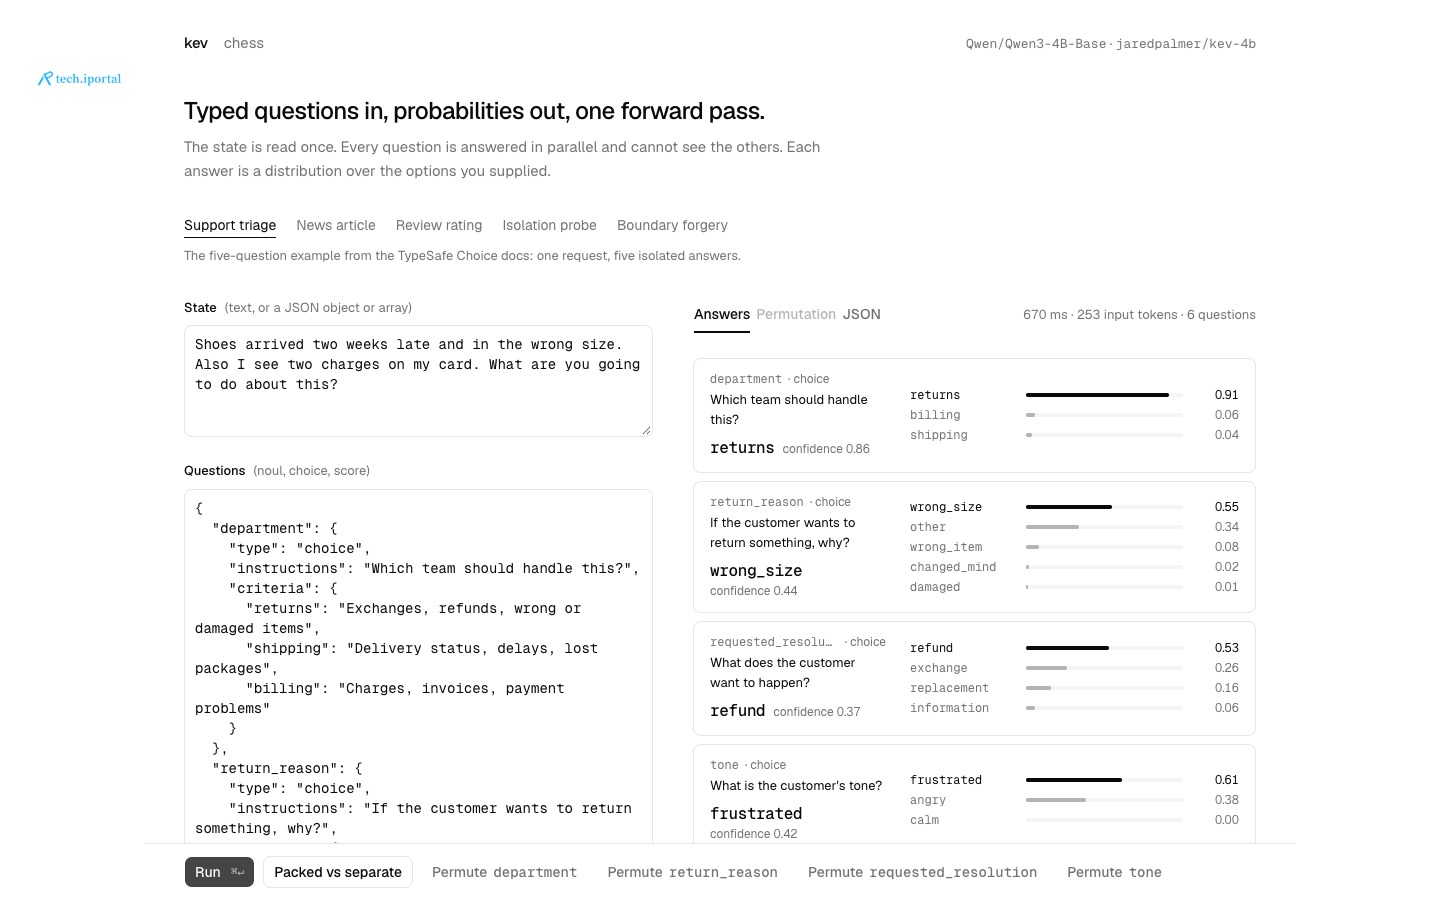
Server ishga tushgandan so'ng, curl yoki TypeSafe SDK orqali savollar yuborish mumkin. Savollar bir nechta turda bo'lishi mumkin: yes/no (noul), multiple‑choice (choice) va rating (score). Har bir savol bir xil matnni baholaydi, lekin savollar o'rtasida ma'lumot almashinuvi yo'q, bu esa izolyatsiyani ta'minlaydi.
Kev‑4B ni Apple M5 chipida bf16 formatida ishga tushirish natijasida 495 ms kechikish va 101 token kirish, 161 token chiqish ko'rsatilgan. Natijada model har bir savolga ehtimollik taqsimoti bilan javob beradi, bu esa foydalanuvchiga qaror qabul qilish jarayonida ishonchlilik darajasini baholash imkonini beradi. Misol uchun, “department” savoliga “returns” tanlovi 0.21 ishonchlilik bilan, lekin “returns” ehtimolligi 0.47 bo'lib, boshqa variantlar ham ko'rsatiladi.
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
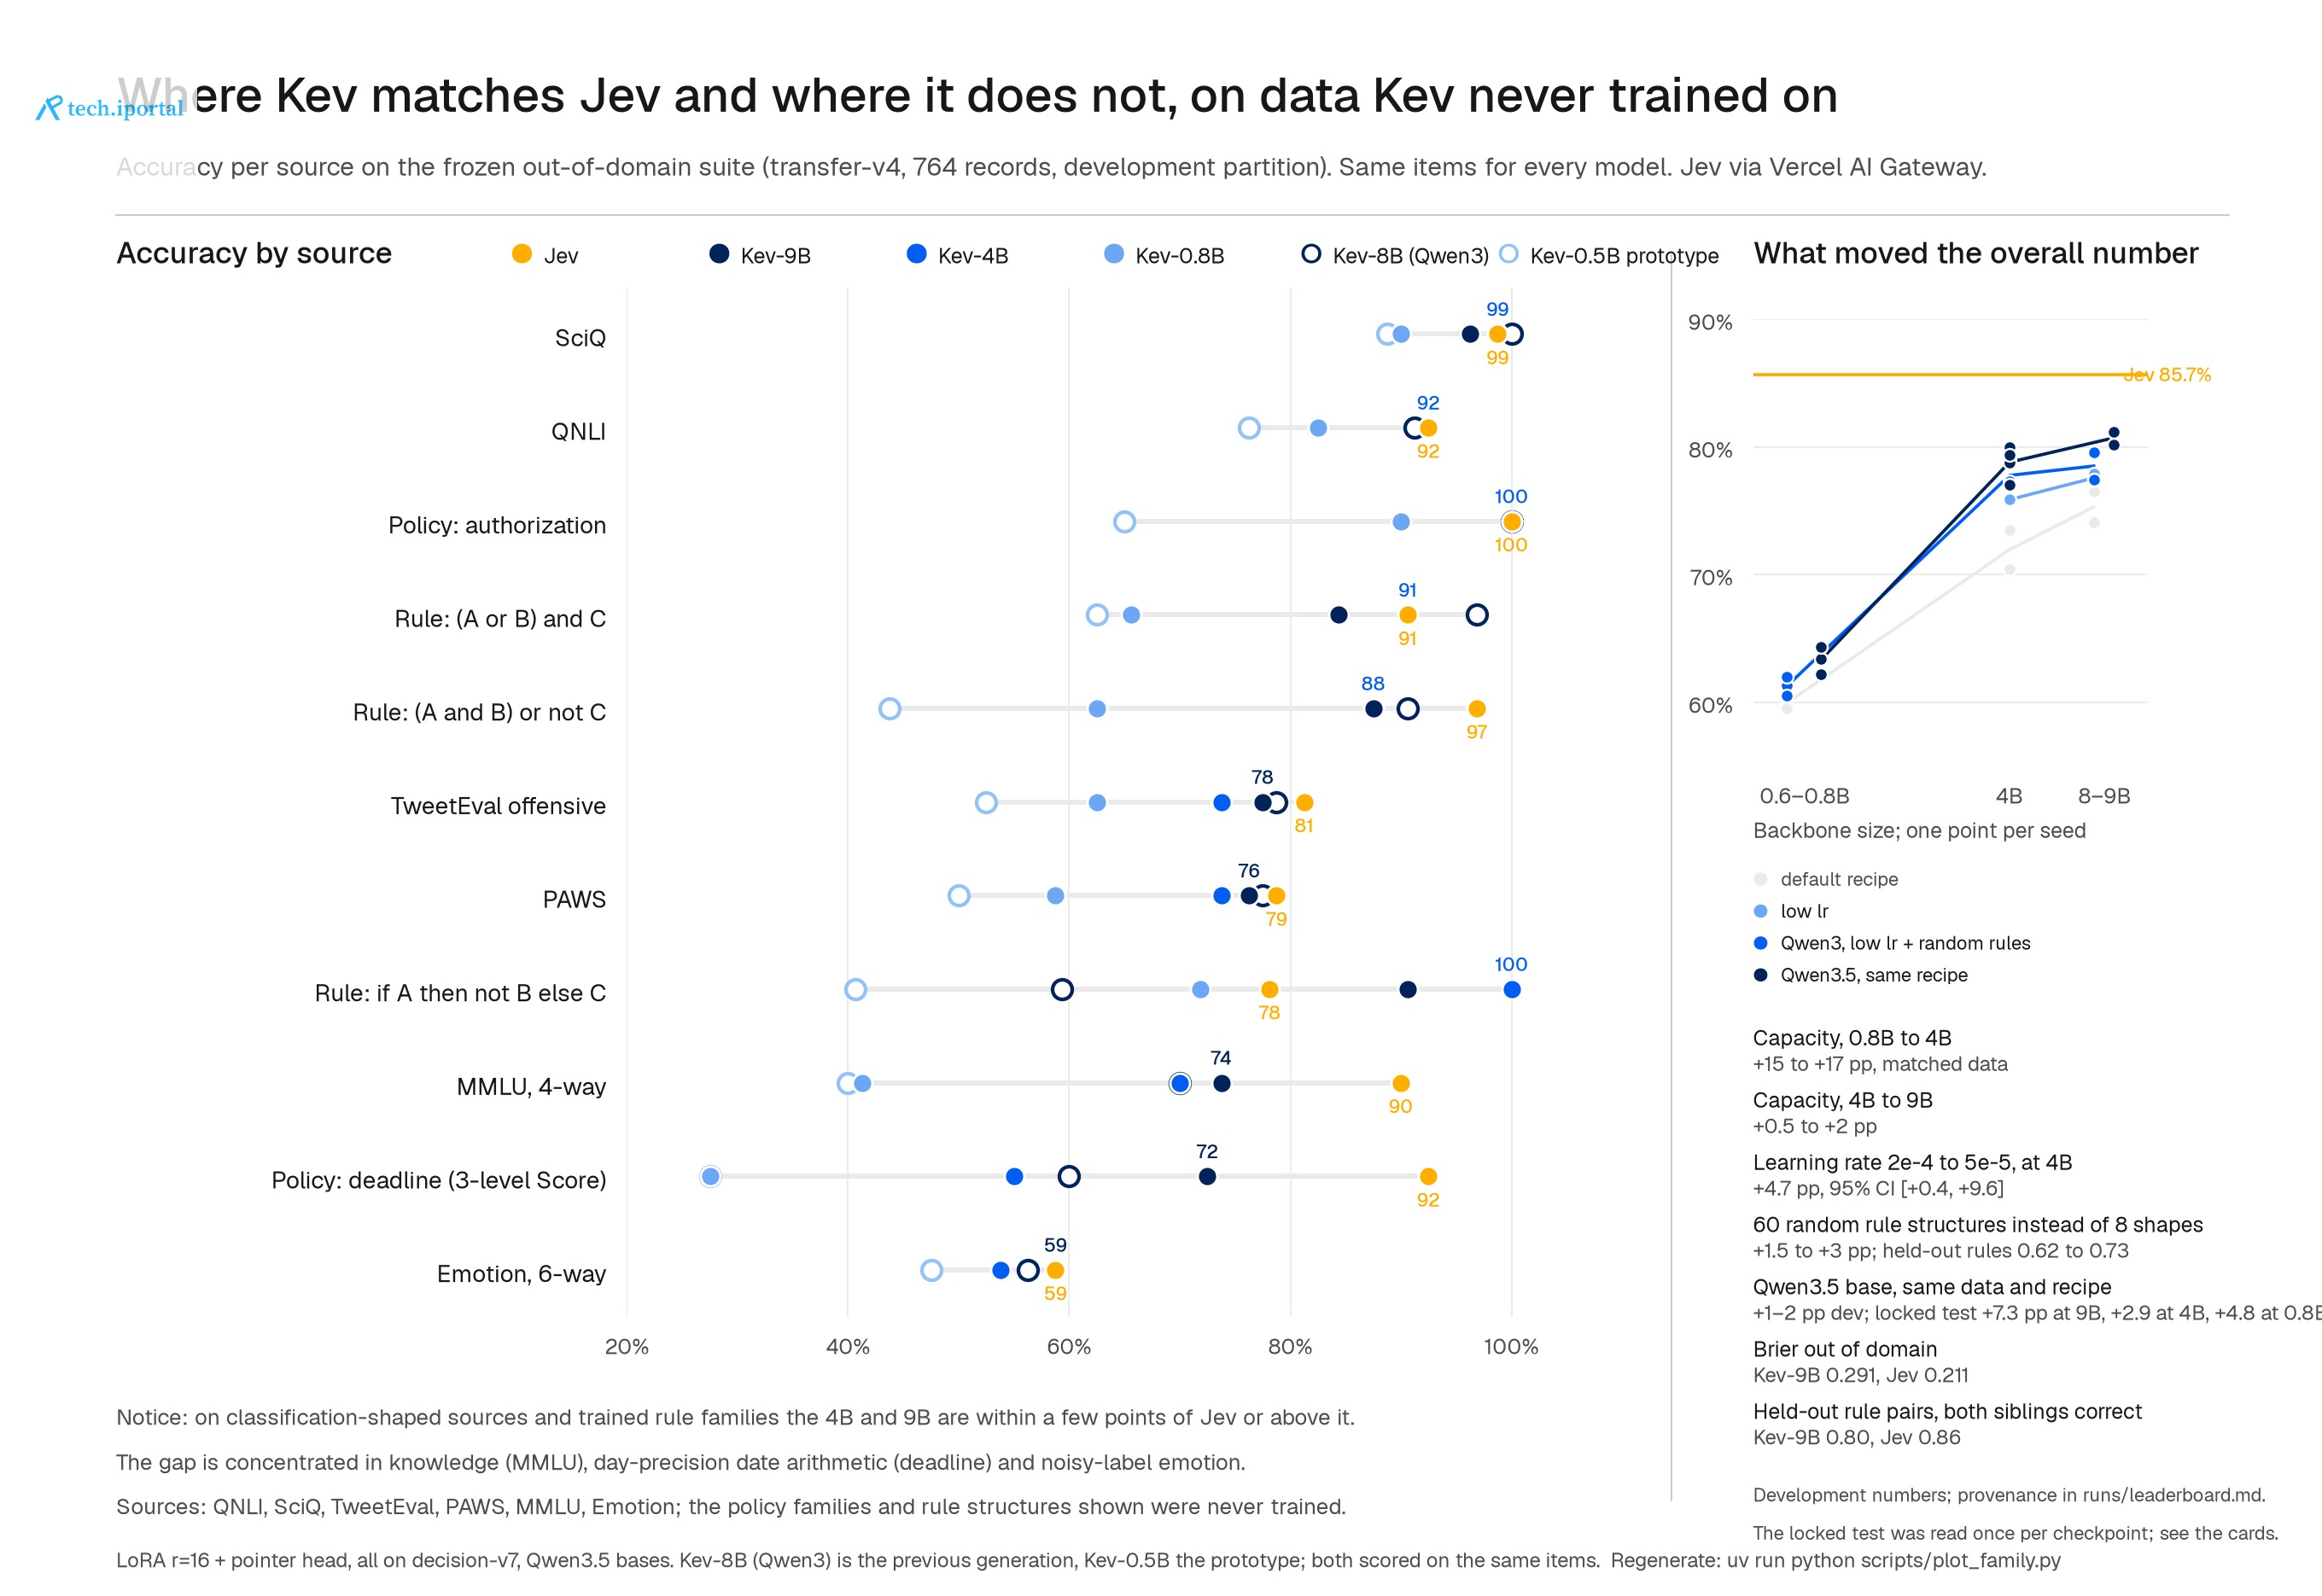
KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009Kev modellarini Jev platformasi bilan solishtirganda, quyidagi jadvalda asosiy ko'rsatkichlar ko'rsatilgan:
curl -s localhost:8009/v1/systemone -H 'content-type: application/json' -d '{
  "state": "Shoes arrived two weeks late and in the wrong size. Also I see two charges on my card.",
  "model": "kev-latest",
  "questions": {
    "department":  {"type": "choice", "instructions": "Which team should handle this?",
                    "criteria": {"returns": "Exchanges, refunds, wrong or damaged items",
                                 "shipping": "Delivery status, delays, lost packages",
                                 "billing": "Charges, invoices, payment problems"}},
    "escalate":    {"type": "noul",  "instructions": "Does this need urgent human attention?"},
    "frustration": {"type": "score", "instructions": "How frustrated is the customer?",
                    "criteria": ["Calm", "Frustrated", "Very angry"]}
}}'Natijalar shuni ko'rsatadiki, Kev‑9B yangi manbalarda Jev ga nisbatan taxminan 4.5 ball farq qiladi, ammo bu farq Jev ning trening ma'lumotlari noaniqligiga bog'liq. Kev modellarining afzalligi – ochiq manba, lokal ishga tushirish va xotira talablariga moslashuvchanlik.
{
  "model": "kev-latest",
  "answers": {
    "department":  { "type": "choice", "choice": "returns", "confidence": 0.21,
                     "probabilities": { "returns": 0.47, "shipping": 0.28, "billing": 0.25 } },
    "escalate":    { "type": "noul", "noul": 0.93 },
    "frustration": { "type": "score", "score": 1.44, "confidence": 0.78,
                     "legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
                     "probabilities": { "0": 0.00, "1": 0.56, "2": 0.44 } }
  },
  "usage": { "input_tokens": 101, "output_tokens": 161 },
  "latency_ms": 495
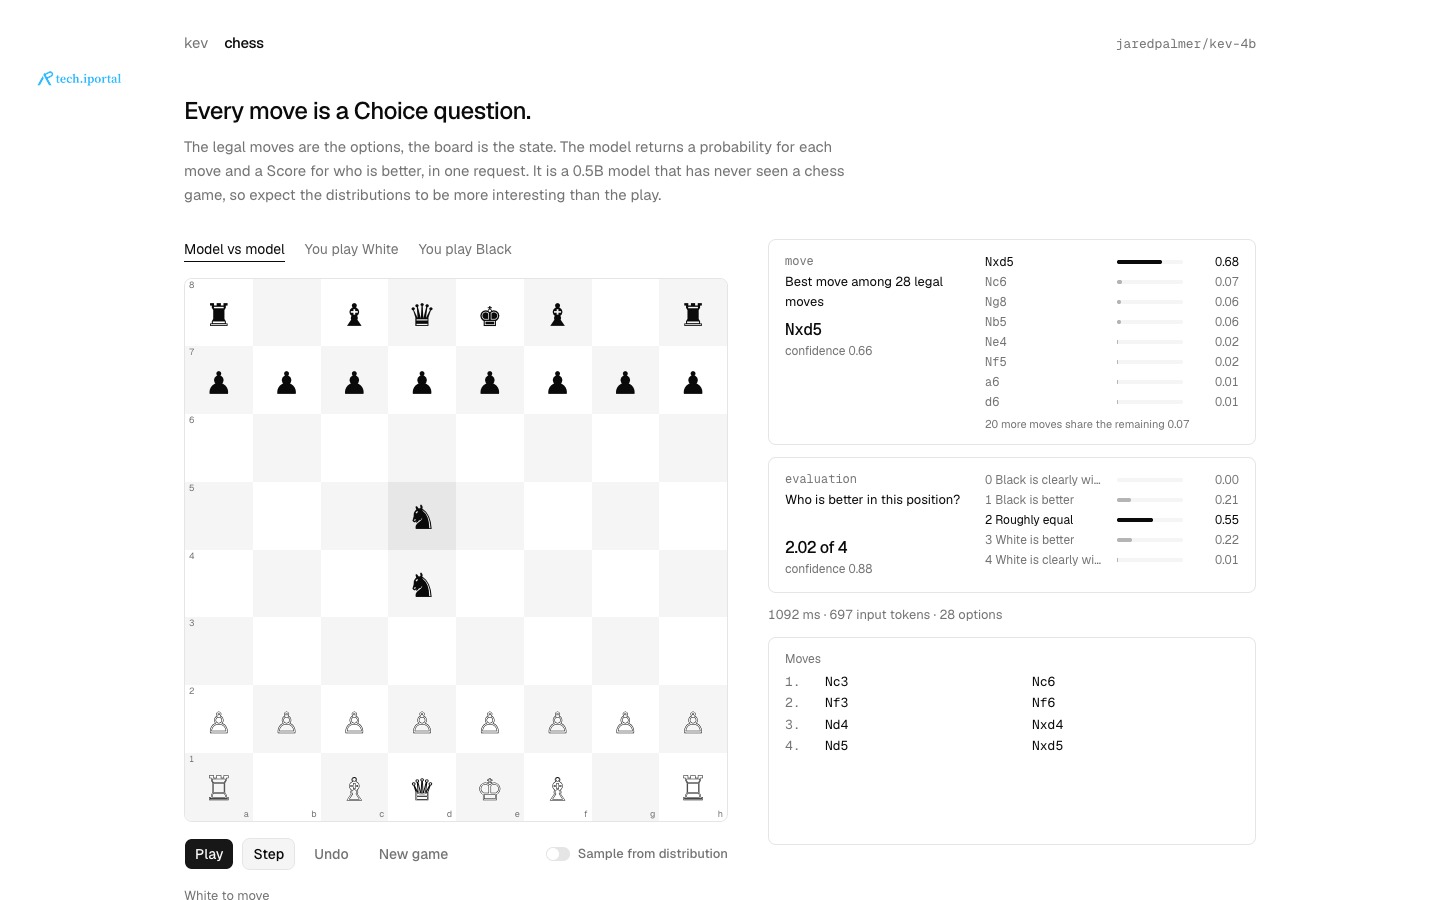
}Kev ni mijoz xizmatlari, savdo‑savdo tahlili yoki ichki qaror qabul qilish tizimlarida qo'llash mumkin. Misol uchun, mijozning qaytarish, kechikkan yetkazib berish yoki to'lov muammolari bo'yicha ticketni tahlil qilishda model har bir bo'limga ehtimollik taqsimoti bilan javob beradi, bu esa avtomatlashtirilgan eskalatsiya va prioritet belgilashga yordam beradi. Shuningdek, Kev o'yin maydonida ham sinovdan o'tkazilgan – shaxmat taxtasini kirish sifatida qabul qilib, har bir yurishni Choice variantlari va Score savoli orqali baholash mumkin.
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient(
    api_key="local",
    base_url="http://127.0.0.1:8009",
    model="kev-latest",
)
response = client.system_one(
    state="I was charged twice. Please fix this ASAP.",
    questions={
        "billing": Noul(instructions="Is this ticket about billing?"),
        "tone": Choice(
            instructions="What is the customer's tone?",
            criteria={"calm": None, "frustrated": None, "angry": None},
        ),
        "urgency": Score(
            instructions="How urgent is this ticket?",
            criteria=["can wait", "this week", "today"],
        ),
    },
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)Kev modellarining asosiy cheklovlari quyidagilardan iborat:
cd playground
npm install
npm run dev -- -p 3001Kelajakda quyidagi yo'nalishlar tadqiq etilishi lozim: modelni 16 GB RAMda ham samarali ishlashga moslashtirish, yangi domenlar uchun transfer o'qitish usullarini qo'shish va API ni REST‑ful emas, balki GraphQL kabi zamonaviy interfeyslar bilan kengaytirish.
Kev ochiq manba bo'lgani sababli, startaplar, kichik bizneslar va tadqiqotchilar uchun arzon, moslashuvchan AI qaror tizimlarini yaratish imkonini beradi. Modelning lokal ishga tushirilishi ma'lumot maxfiyligini ta'minlaydi, bu esa sog'liq, moliya yoki hukumat sektorlarida maxsus talablar bo'lgan hollarda muhim afzallikdir. Shuningdek, Python SDK va Node.js playground orqali foydalanuvchilar tezda prototip yaratib, savollarni turli variantlarda sinab ko'rishlari mumkin.
Kev – Qwen3.5 asosidagi kichik, lekin kuchli qaror modellarining to'liq ochiq manbali to'plami bo'lib, turli o'lchamdagi modellari, bir nechta savol turlari va lokal server integratsiyasi bilan ajralib turadi. Modelning aniq ehtimollik chiqishi, foydalanuvchilarga qaror qabul qilish jarayonida yanada chuqurroq tahlil qilish imkonini beradi. Kelajakda xotira talablari va platforma qo'llab-quvvatlashini kengaytirish orqali Kev yanada ko'proq sohalarda amaliy qo'llanilish imkoniyatiga ega bo'ladi.
Asl manba: github.com
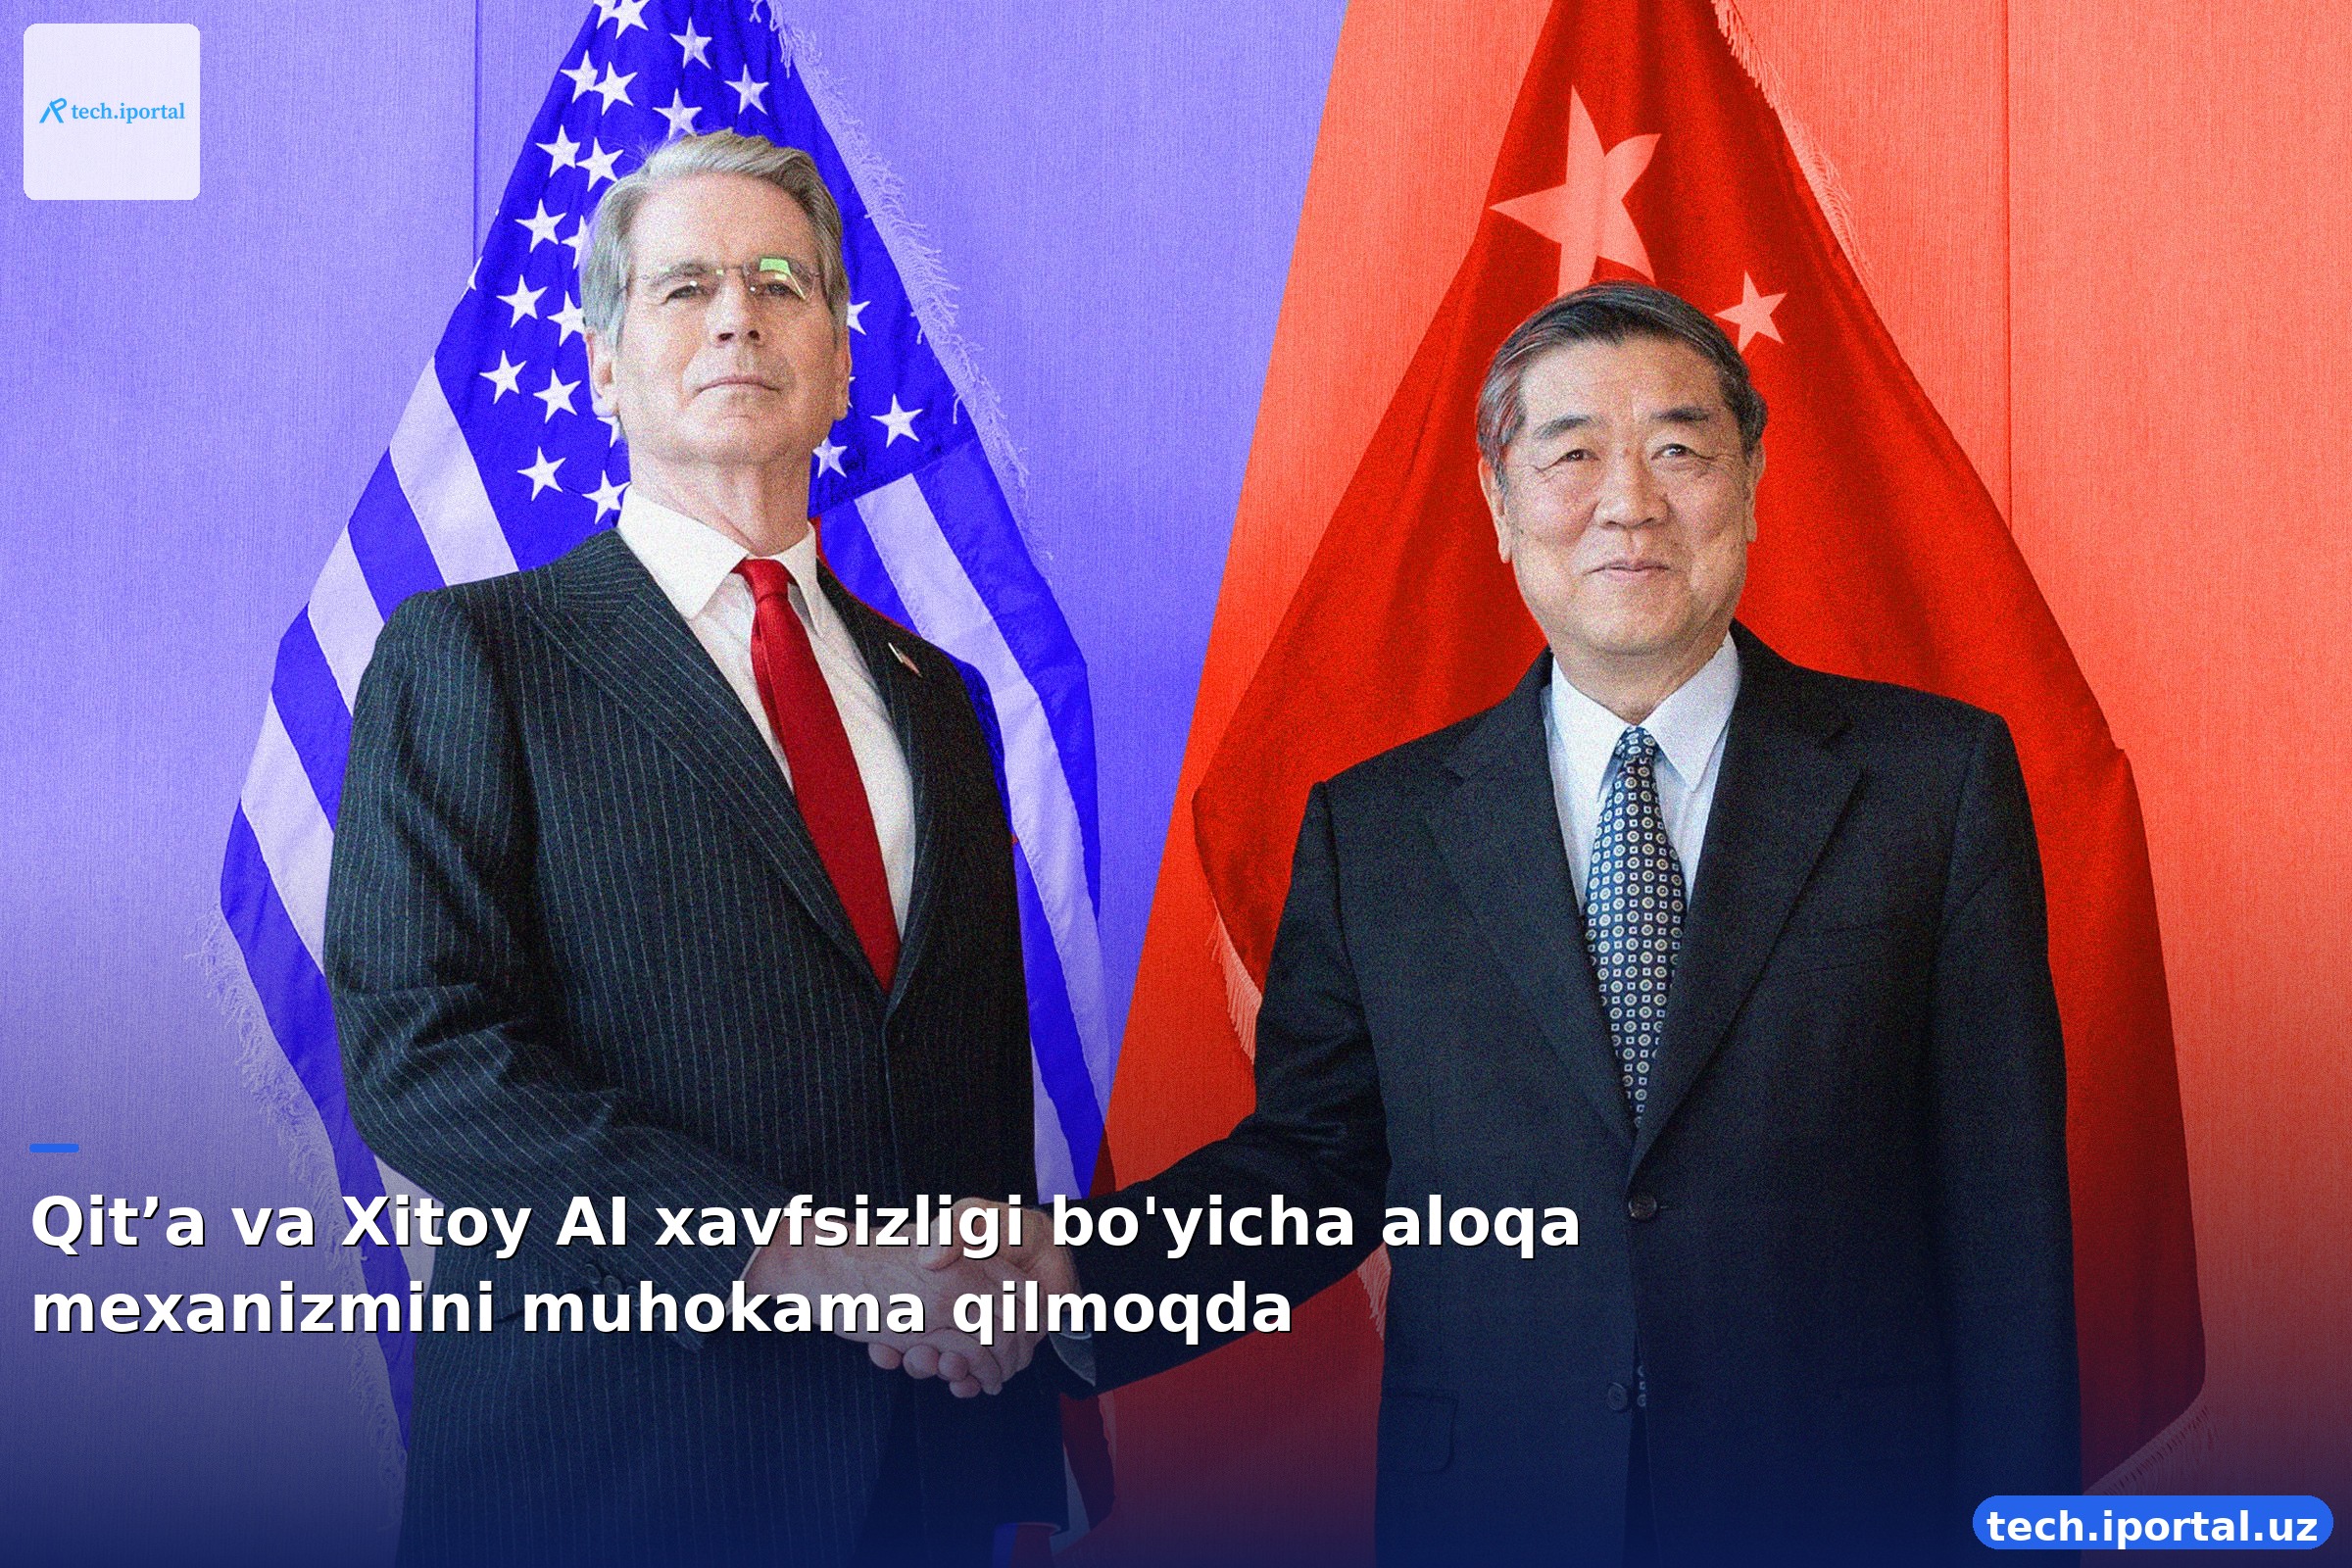
Qitʼa va Xitoy rasmiylari AI xavfsizligi bilan bog'liq milliy xavfsizlik xavflarini bir-biriga bildirish mexanizmini muhokama qilishni boshladilar.
Mini-AGI — bu 8 GB VRAM bilan o'zini o'zi o'rganadigan, o'z arxitekturasini yig'ish va har qanday ma'lumotdan o'rganish qobiliyatiga ega model. Bu model har qanday PC yoki laptopda ishlashi mumkin.
BBC maqolasiga ko'ra, ba'zi AI kompaniyalarida ishlaydigan ishchilar AI texnologiyasini insoniyat uchun xavf deb bilmaydilar.
DAPO algoritmi va kod bazasi katta hajmdagi LLMlarni mustahkam RL orqali yaxshilashga yo'naltirilgan, 50%+ AIME 2024 natijasi bilan ochiq manbali.