Sun'iy intellekt
Qitʼa va Xitoy AI xavfsizligi bo'yicha aloqa mexanizmini muhokama qilmoqda
Qitʼa va Xitoy rasmiylari AI xavfsizligi bilan bog'liq milliy xavfsizlik xavflarini bir-biriga bildirish mexanizmini muhokama qilishni boshladilar.
Dastlabki qadamlar – katta til modellarini (LLM) mustahkam reinforcement learning (RL) bilan o‘rgatish har doim murakkab bo‘lib kelgan. ByteDance Seed va Tsinghua Air jamoalari DAPO nomli yangi algoritmni taqdim etish orqali bu muammoni yangi darajaga ko‘tarishdi. DAPO nafaqat algoritmik yondashuvni, balki to‘liq kod infratuzilmasi, ma’lumotlar to‘plami va tayyor model vaznlarini ham ochiq manbali qilib e’lon qildi.
RL asosida LLMni o‘rgatishda asosiy muammo – exploration (kashfiyot) va exploitation (foydalanish) o‘rtasidagi muvozanatni saqlash. DAPO Decoupled Clip and Dynamic Sampling Policy Optimization (DAPO) algoritmi orqali bu muammoni ikki qismga bo‘ldi: Clip mexanizmi yordamida policy gradient (PG) yo‘qotishini barqarorlashtirish, va dinamik namuna olish (Dynamic Sampling) orqali trening ma’lumotlarini vaqtinchalik ravishda qayta tarqatish. Bu yondashuv token‑darajali PG yo‘qotmasiz ham yuqori natijalar berishini ko‘rsatdi.
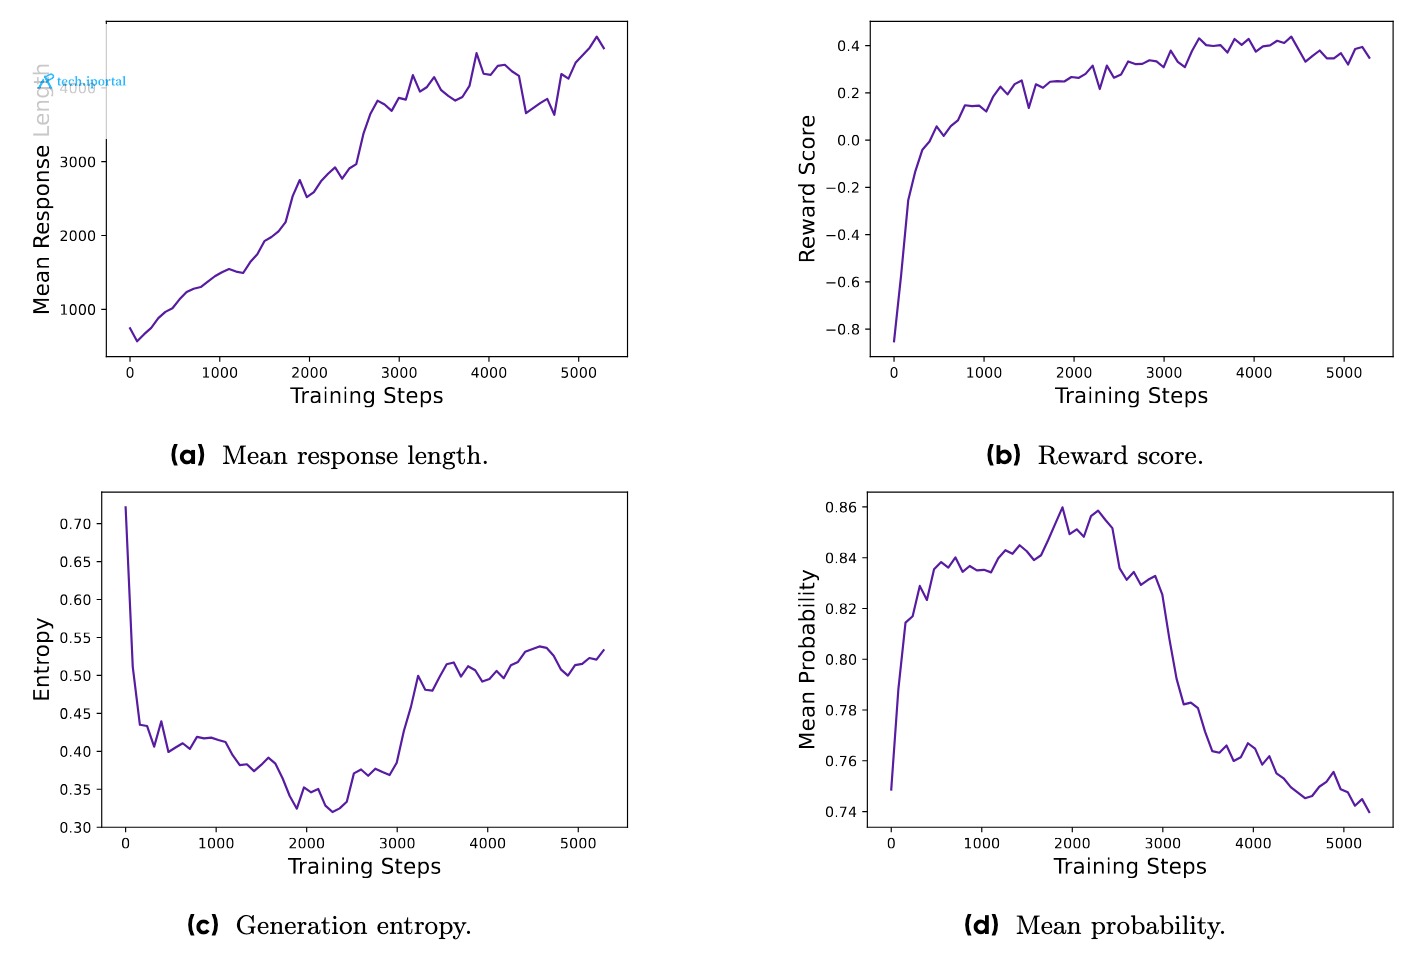
2025‑yil may oyida jamoa DAPO ning to‘liq versiyasini wandb platformasida qayd etdi va AIME 2024 testida 50%+ natija (50 ball) erishdi. Bu natija avvalgi SoTA DeepSeek‑R1‑Zero‑Qwen‑32B modelidan ancha yuqori bo‘lib, aynan 50% trening bosqichida erishildi. Natijalar quyidagi metrikalarda ham barqaror o‘sishni ko‘rsatdi:
Jamoa verL (versatile RL) freymvorkini asos qilib oldi. DAPO ni ishga tushirish uchun tavsiya etilgan muhit conda orqali yaratiladi:
conda create -n dapo python=3.10
conda activate dapo
pip install -r requirements.txt
Model inference kodida vllm kutubxonasi, SamplingParams va LLM sinflari ishlatiladi. Misol uchun, quyidagi snippet AIME 2024 savollariga javob berish uchun modelni chaqiradi:
import torch
from transformers import AutoTokenizer
from vllm import SamplingParams, LLM

model = "BytedTsinghua-SIA/DAPO-Qwen-32B"
tokenizer = AutoTokenizer.from_pretrained(model)
llm = LLM(model=model, dtype=torch.bfloat16, tensor_parallel_size=8, gpu_memory_utilization=0.95)
params = SamplingParams(temperature=1.0, top_p=0.7, max_tokens=20480)
Shuningdek, Ray Serve yordamida serve run eval.llm:build_app buyrug‘i orqali modelni xizmat sifatida joylashtirish mumkin.
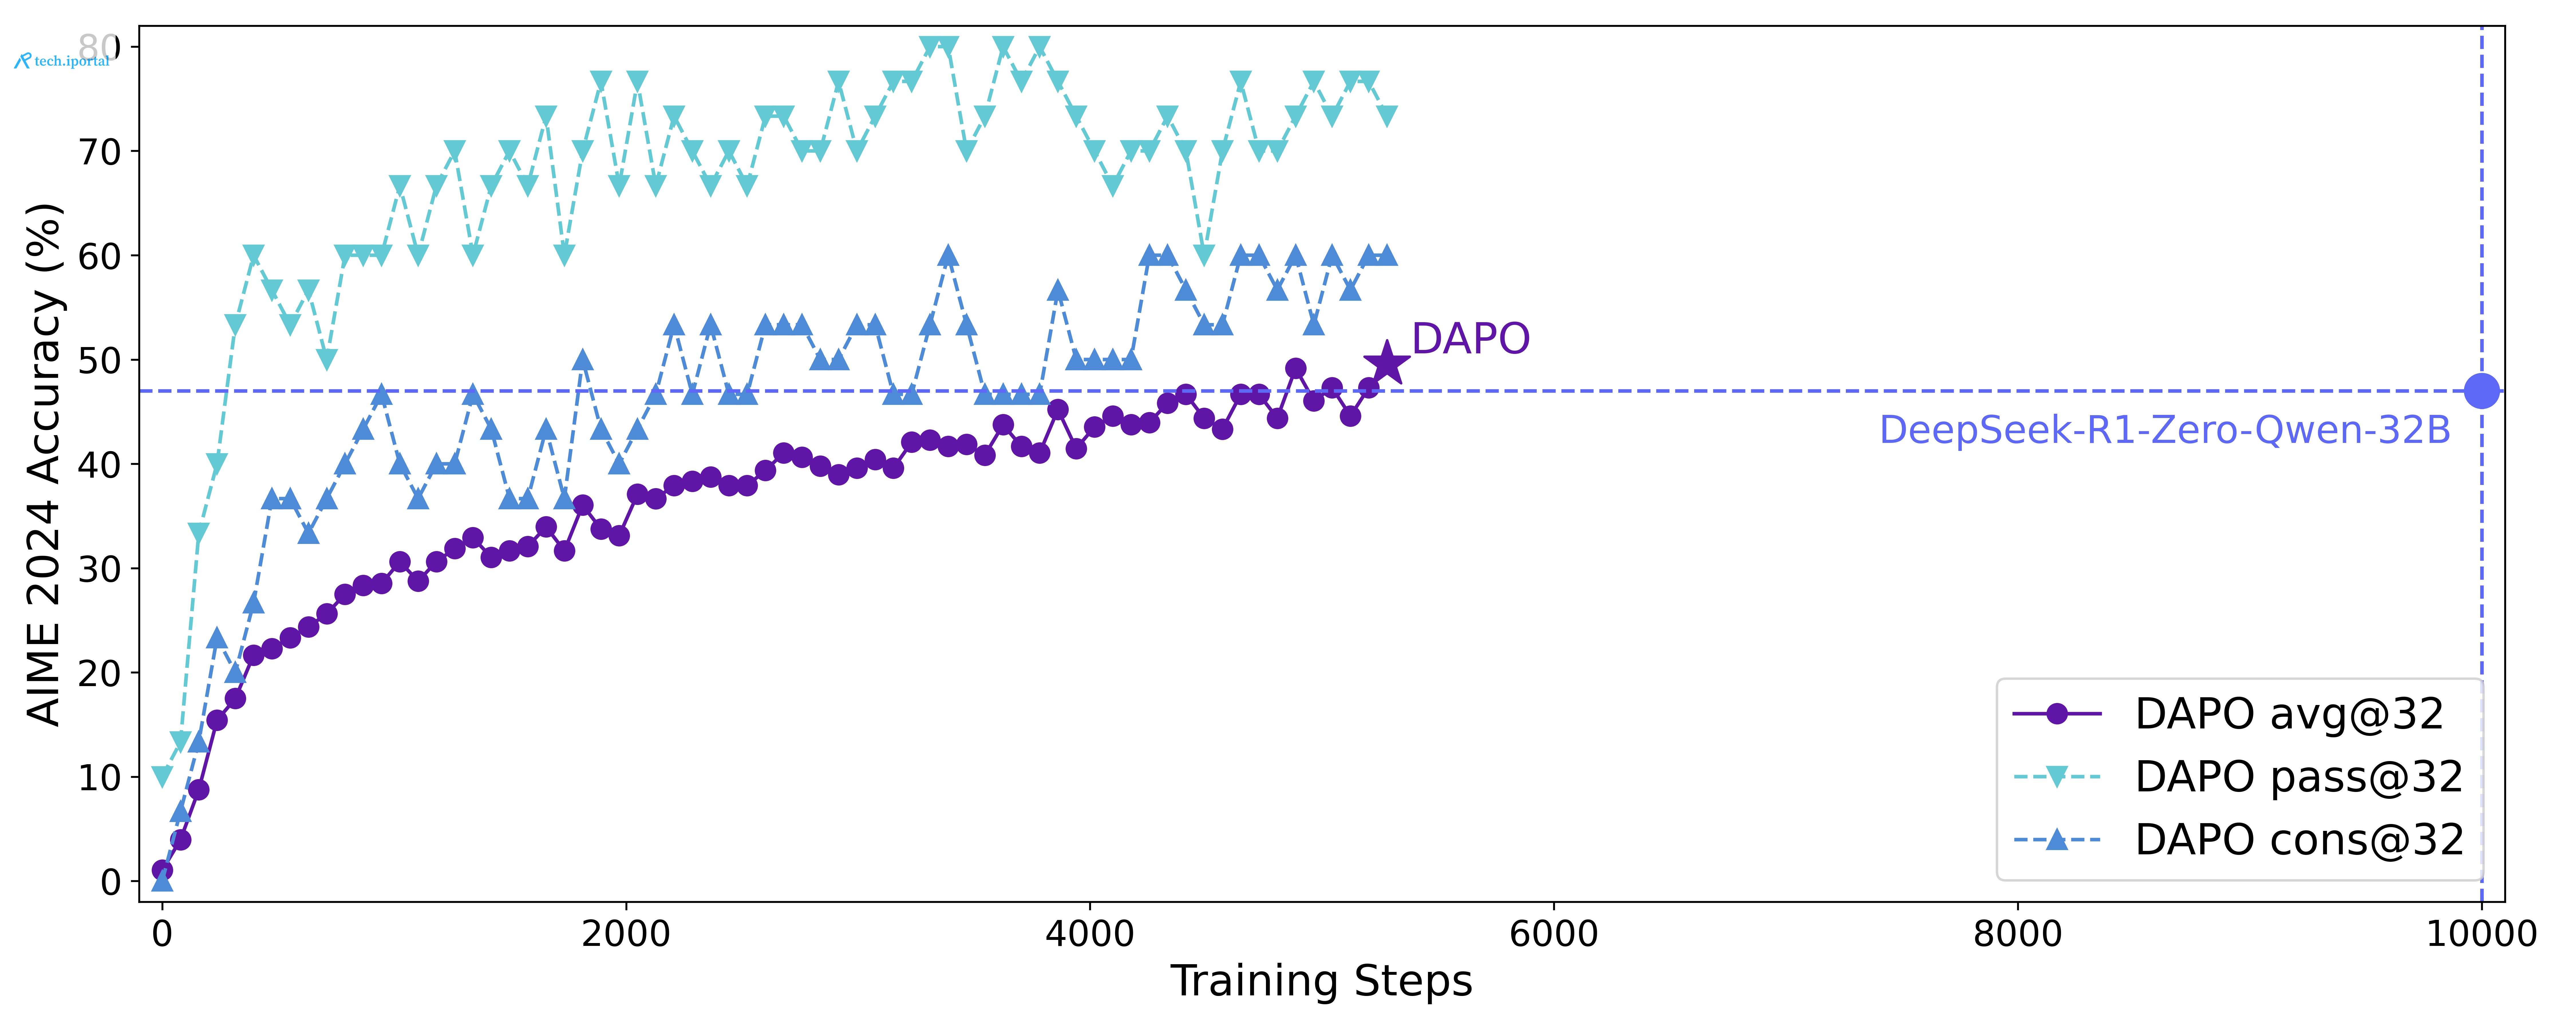
DAPO ning avvalgi versiyasi token‑darajali PG yo‘qotmasiz 44% AIME 2024 natijasi bergan. Bu versiya Dynamic Sampling va Clip mexanizmini birgalikda qo‘llagan holda, keyinchalik chiqarilgan to‘liq versiyada 50%+ ga ko‘tarildi. Raqobatchi DeepSeek‑R1‑Zero‑Qwen‑32B esa 50% trening bosqichida 48 ballga yetgan. DAPO ning yirik parallelizm (8‑GPU tensor parallel) va yuqori GPU xotira samaradorligi (95%) uni amaliy loyihalarda yanada samarali qiladi.
Hozirgi bosqichda DAPO faqat Qwen2.5‑32B asosida sinovdan o‘tkazilgan, shuning uchun boshqa arxitekturalarga (Llama‑2, Mistral) moslashuvchanligi hali tasdiqlanmagan. Shuningdek, dinamik namuna olish strategiyasining optimal parametrlarini avtomatik tanlash usullari hali tadqiqot bosqichida. Kelgusida jamoa bu parametrlarni meta‑optimallashtirish orqali yanada avtomatlashtirishni rejalashtirgan.
conda create -n dapo python=3.10
conda activate dapo
pip3 install -r requirements.txtOchiq manbali bo‘lishi DAPO ni ilmiy hamjamiyat, startaplar va korporativ tadqiqotchilar uchun qulay qiladi. Har bir foydalanuvchi kodni o‘zgartirishi, yangi ma’lumotlar to‘plamlarini qo‘shishi yoki algoritmning boshqa komponentlarini sinab ko‘rishi mumkin. Bu esa RL‑ga asoslangan LLMlarni yanada demokratiklashtiradi, maxsus infratuzilmasiz ham yuqori darajadagi matematik mantiqni o‘rganish imkonini beradi.
import torch
from transformers import AutoTokenizer
from vllm import SamplingParams, LLM

examples = [
    {
        "question": "Solve the following math problem step by step. The last line of your response should be of the form Answer: $Answer (without quotes) where $Answer is the answer to the problem.\n\nFind the largest possible real part of \\[(75+117i)z+\\frac{96+144i}{z}\\]where $z$ is a complex number with $|z|=4$.\n\nRemember to put your answer on its own line after \"Answer:\".",
        "answer": "540"
    },
    {
        "question": "Solve the following math problem step by step. The last line of your response should be of the form Answer: $Answer (without quotes) where $Answer is the answer to the problem.\n\nEvery morning Aya goes for a $9$-kilometer-long walk and stops at a coffee shop afterwards. When she walks at a constant speed of $s$ kilometers per hour, the walk takes her 4 hours, including $t$ minutes spent in the coffee shop. When she walks $s+2$ kilometers per hour, the walk takes her 2 hours and 24 minutes, including $t$ minutes spent in the coffee shop. Suppose Aya walks at $s+\\frac{1}{2}$ kilometers per hour. Find the number of minutes the walk takes her, including the $t$ minutes spent in the coffee shop.\n\nRemember to put your answer on its own line after \"Answer:\".",
        "answer": "204"
    },
    {
        "question": "Solve the following math problem step by step. The last line of your response should be of the form Answer: $Answer (without quotes) where $Answer is the answer to the problem.\n\nLet $\\mathcal{B}$ be the set of rectangular boxes with surface area $54$ and volume $23$. Let $r$ be the radius of the smallest sphere that can contain each of the rectangular boxes that are elements of $\\mathcal{B}$. The value of $r^2$ can be written as $\\frac{p}{q}$, where $p$ and $q$ are relatively prime positive integers. Find $p+q$.\n\nRemember to put your answer on its own line after \"Answer:\".",
        "answer": "721"
    }
]


def main():
    model = "BytedTsinghua-SIA/DAPO-Qwen-32B"

    tokenzier = AutoTokenizer.from_pretrained(model)

    llm = LLM(
        model=model,
        dtype=torch.bfloat16,
        tensor_parallel_size=8,
        gpu_memory_utilization=0.95
    )

    sampling_params = SamplingParams(
        temperature=1.0,
        top_p=0.7,
        max_tokens=20480
    )

    for example in examples:
        question = example["question"]
        answer = example["answer"]
        output = llm.generate(
                    prompts=tokenzier.apply_chat_template(conversation=[{"content": question, "role": "user"}],
                                                          add_generation_prompt=True,
                                                          tokenize=False),
                    sampling_params=sampling_params
                )
        print(f"***QUESTION***:\n{question}\n***GROUND TRUTH***:\n{answer}\n***MODEL OUTPUT***:\n{output[0].outputs[0].text}\n")
        print("-"*100)

if __name__ == "__main__":
    main()
Umuman olganda, DAPO katta hajmdagi LLMlar uchun RL treningini yanada barqaror, samarali va ochiq manbali qilishga qaratilgan muhim qadamdir. Algoritmik yangiliklar, kod infratuzilmasi va tayyor model vaznlari birgalikda ilmiy tadqiqotlar va amaliy ilovalar uchun mustahkam poydevor yaratadi. Kelgusida bu texnologiya yanada ko‘proq domen‑maxsus modellarni (masalan, tibbiyot, moliya) RL yordamida takomillashtirishda qo‘llanilishi kutilmoqda.
Asl manba: github.com
Qitʼa va Xitoy rasmiylari AI xavfsizligi bilan bog'liq milliy xavfsizlik xavflarini bir-biriga bildirish mexanizmini muhokama qilishni boshladilar.
Kev modeli Qwen3.5 bazasida yaratilgan, 0.8B, 4B va 9B o'lchamdagi kichik qaror modellarini taklif etadi; o'zgaruvchan savollar, lokal server va Python SDK bilan integratsiya imkoniyatlari.
Mini-AGI — bu 8 GB VRAM bilan o'zini o'zi o'rganadigan, o'z arxitekturasini yig'ish va har qanday ma'lumotdan o'rganish qobiliyatiga ega model. Bu model har qanday PC yoki laptopda ishlashi mumkin.
BBC maqolasiga ko'ra, ba'zi AI kompaniyalarida ishlaydigan ishchilar AI texnologiyasini insoniyat uchun xavf deb bilmaydilar.