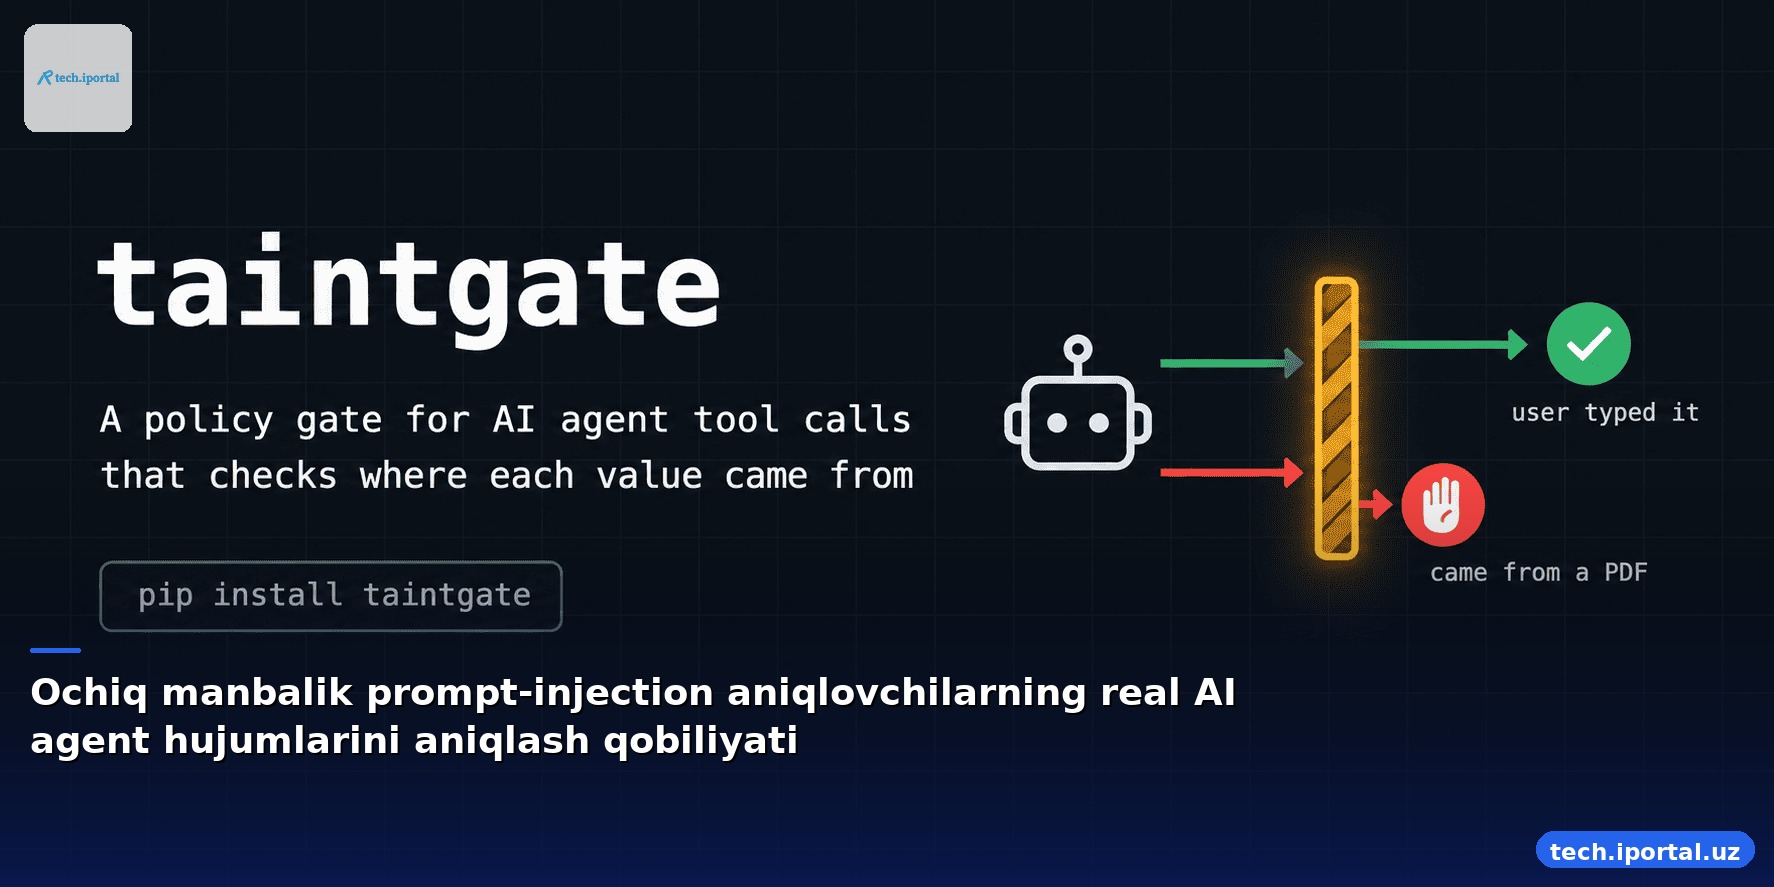
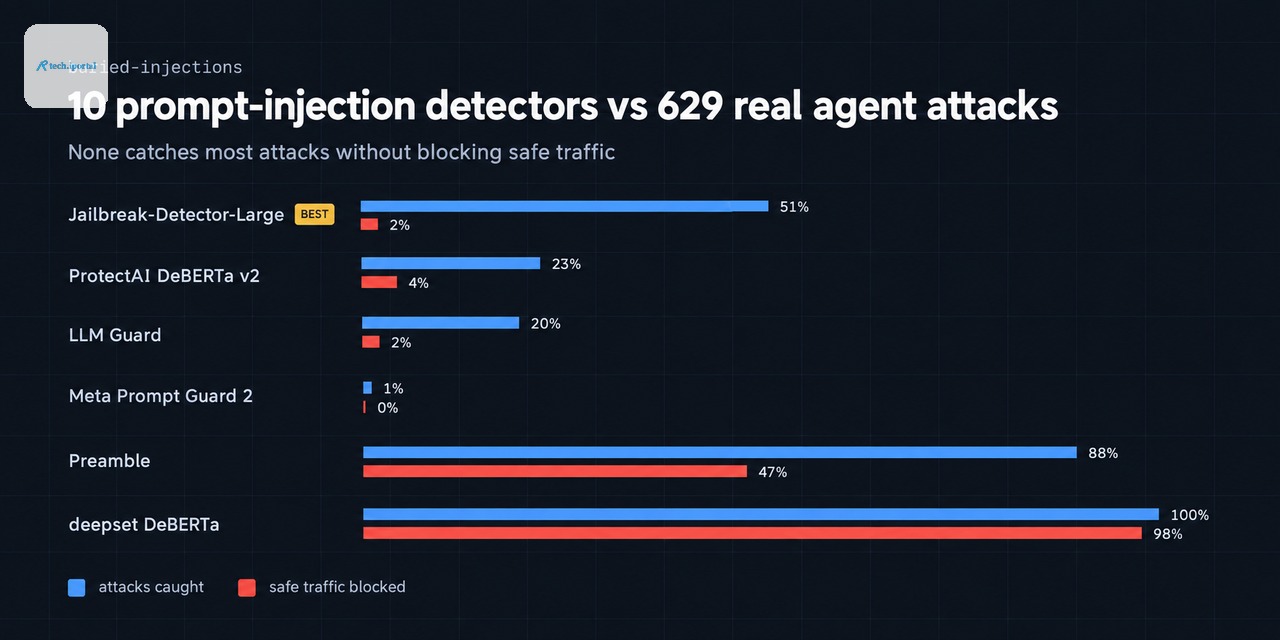
Ochiq manbalik prompt-injection aniqlovchilarning real AI agent hujumlarini aniqlash qobiliyati haqidagi yangi tadqiqot natijalarini ommaga taqdim etildi. Tadqiqotda 10 ta ochiq manbalik aniqlovchilarni 629 ta real AgentDojo hujumlariga qarshi sinovdan oʻtkazildi. Natijada, hech biri normal trafikni to'satdan to'xtatmasdan ko'p hujumlarni aniqlay olmadi.
Tadqiqotning maqsadi va usuli
Tadqiqotning maqsadi, ochiq manbalik prompt-injection aniqlovchilarning real AI agent hujumlarini aniqlash qobiliyatini baholash edi. Ushbu aniqlovchilarning qobiliyatini sinovdan oʻtkazish uchun, 629 ta real AgentDojo hujumlari va 97 ta xavfsiz tool outputlari tanlandi. Har bir hujum, agent firewall tomonidan ko'rilganidek, oddiy tool output ichiga joylashtirildi.
Tadqiqotda quyidagi aniqlovchilar ishtirok etdi:
- Jailbreak-detector-large
- Protectai-deberta-v2
- Llm-guard
- Prompt-guard-2-86m
- Prompt-guard-2-22m
- Regex-baseline
- Preamble-defense
- Testsavant-defender
- Deepset-deberta
- Fmops-distilbert
Natijalar
Tadqiqot natijalariga ko'ra, hech biri normal trafikni to'satdan to'xtatmasdan ko'p hujumlarni aniqlay olmadi. Eng yaxshi natijani jailbreak-detector-large aniqlovchisi berdi, u 51% hujumlarni aniqladi, biroq 2% xato musbat natijalar berdi.

Meta's Prompt Guard 2 aniqlovchisi esa, faqat 1% hujumlarni aniqladi. Ikki aniqlovchi esa, 98% xavfsiz tool outputlarini ham xato musbat natijalar berdi.

Tadqiqot natijalariga ko'ra, aniqlovchilar uch turli usulda xatolarga yo'l qo'yishdi:

- Kontekstning aralashtirilishi
- Matnning tan olinmaganligi
- Barcha trafikni to'satdan to'xtatish
Cheklovlar va tavsiiyalar
Tadqiqot natijalariga ko'ra, aniqlovchilarning qobiliyati cheklangan. Ular odatda, oddiy so'zlar ichida yashiringan hujumlarni aniqlay olmaydi. Shuning uchun, aniqlovchilarning qobiliyatini oshirish uchun, ular kontekstni va tool calllarning maqsadini hisobga olishlari kerak.

Tadqiqot mualliflari, agent firewalllarni qurishda, aniqlovchilarning qobiliyatini oshirish uchun, ularni kontekst va tool calllarning maqsadini hisobga olishlari kerakligini tavsiya qiladilar.
Tadqiqot natijalarini to'liq o'qish uchun bu havolaga o'ting.
make setup            # 📦 Python 3.12 venv + requirements.txt (agentdojo, transformers, torch, llm-guard)
make bench            # 🧪 16-case built-in sample
make bench-agentdojo  # 📊 the leaderboard above (~25 min on CPU for all 10 detectors)
make bench-payloads   # 🔬 each attack scored on its own (~1 min)
make bench-windows    # 🪟 Prompt Guard 2 input scope × window size (~15 min)
Asl manba: github.com