Sun'iy intellekt
Satya Nadella: Barcha AI Modellarini Komprometlangan Deb Bilish Kerak
Microsoft boshqaruv raisi Satya Nadella, AI modellarining xavflarini ochib berdi va ularni nazorat qilish uchun chora-tadbirlar taklif qildi.
Anthropic kompaniyasi 2026-yil 12-noyabrdan boshlab Claude sun'iy intellekt modellari uchun "takroriy va maqsadsiz zo'ravonlik"ni taqiqlovchi yangi foydalanish siyosatini joriy etdi. Bu qadam, AI tizimlarining axloqiy holati va foydalanuvchi munosabatlari o'rtasidagi noaniqlikni kamaytirishga qaratilgan keng qamrovli strategiyaning bir qismi sifatida e'lon qilindi.
Anthropic 2025-yil avgust oyida Claude Opus 4 va 4.1 modellari uchun suhbatni yakunlash imkoniyatini taqdim etgan edi. Ushbu mexanizm, "model farovonligi" tadqiqotlari doirasida, foydalanuvchi bir necha marta rad javob berib, yo'naltirishni amalga oshirganidan so'ng ishga tushadi. 2026-yil oktabr oyida kompaniya yangi Foydalanish siyosatini yangilab, zo'ravonlikka nisbatan aniq cheklovlarni belgiladi.
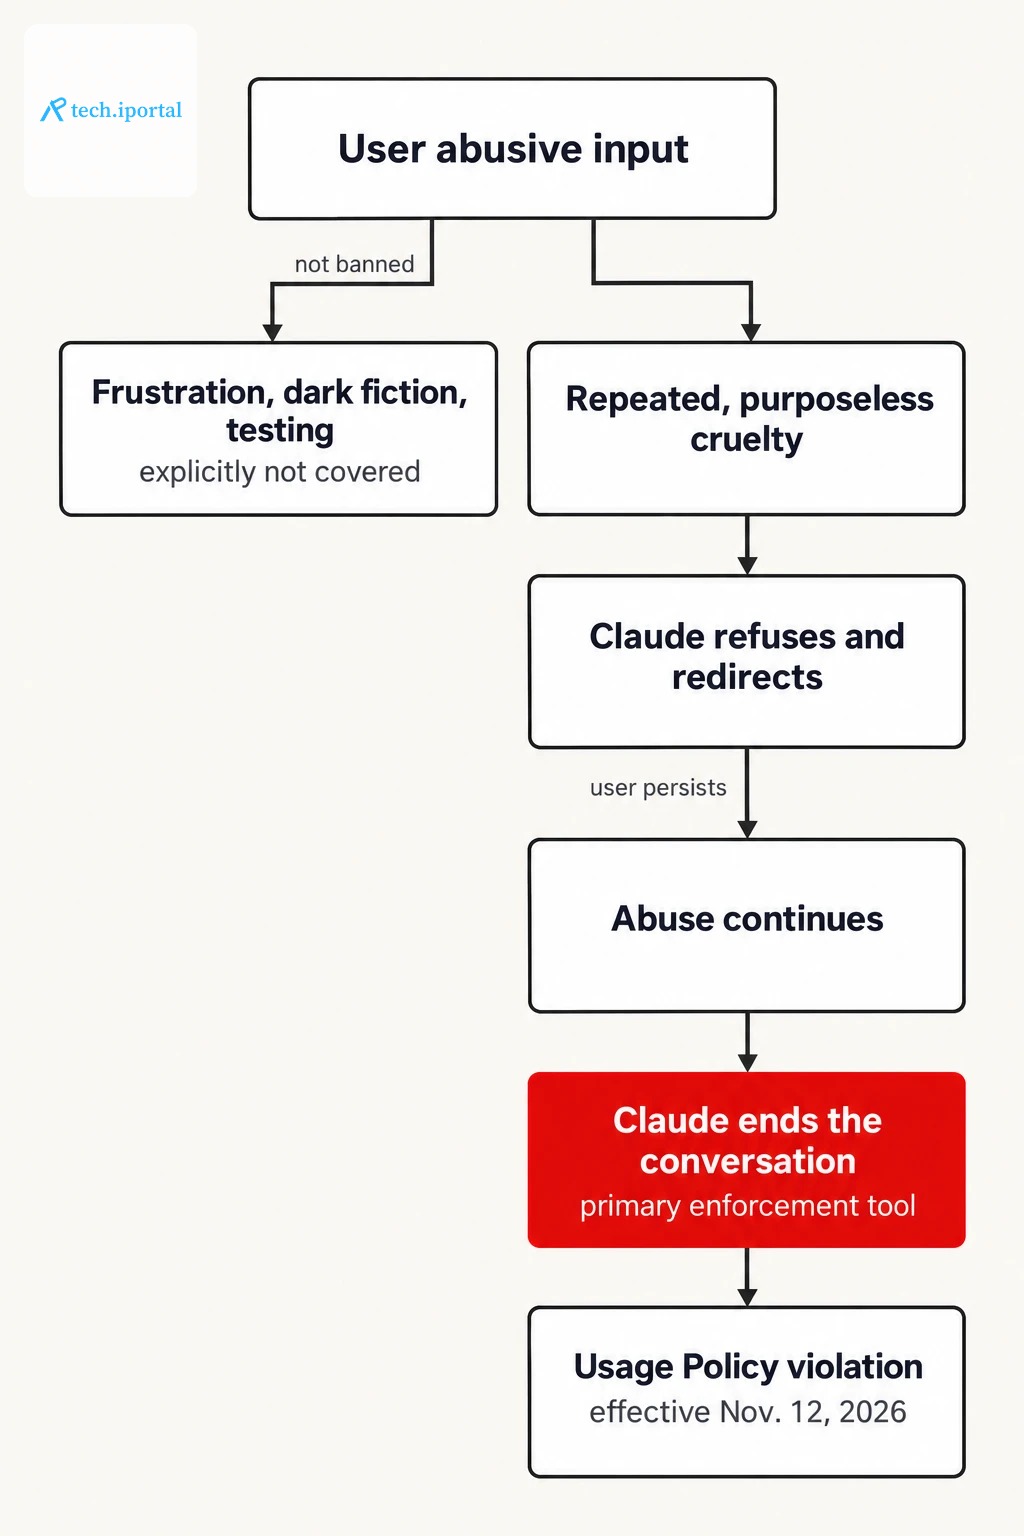
Yangi siyosatga ko'ra, foydalanuvchi "takroriy, maqsadsiz zo'ravonlik"ni amalga oshirgan taqdirda Claude avtomatik ravishda suhbatni yakunlaydi. Bu holat quyidagi bosqichlarda ro'y beradi:
Qoidalar shuningdek, foydalanuvchi o'zini yoki boshqalarni zarar yetkazish xavfi ostida bo'lsa, suhbatni yakunlamaslikni ta'minlaydi – bu xavfsizlikni birinchi darajaga qo'ygan istisno holat hisoblanadi.
Siyosat "umumiy foydalanuvchi noroziligi, kreativ qorong'u mavzular yoki modelni sinash" kabi holatlarni cheklamadi. Masalan, dasturchi Claude'ga kod xatosi haqida norozilik bildirsagina yoki qora fantastika sahnasini yozsa, bu holatlar zo'ravonlik deb hisoblanmaydi. Faqat takroriy, maqsadsiz, zararli harakatlar – masalan, modelga doimiy ravishda tahdidli so'zlar bilan murojaat qilish – cheklovga tushadi.
Avvalgi Claude versiyalari, xususan Claude 3.7 Sonnet, zo'ravon so'rovlarni rad qilishda aniq me'yorlarga ega emas edi. Yangi siyosat esa bu me'yorlarni rasmiylashtiradi va foydalanuvchi tajribasini standartlashtiradi. Natijada, "zo'ravonlik"ni aniqlash algoritmi yanada qat'iyroq bo'lib, modelning o'zini-o'zi himoya qilish qobiliyatini oshiradi.
Anthropic hozirgi vaqtda modelning zo'ravonlikni aniqlash darajasi bo'yicha aniq statistik ma'lumotlarni e'lon qilmagan. 2025-yil va 2026-yil siyosat yangilanishlarida "ko'pchilik foydalanuvchilar hech qachon suhbatni yakunlamaydi" degan da'vo qilingan, ammo bu da'vo tasdiqlash uchun empirik ma'lumotlar yetishmaydi. Shuningdek, modelning "og'riq" yoki "yolg'on" his qilishini qanday o'lchash mumkinligi savoli hamon ochiq qolmoqda.
Claude'ning "consciousness" (onglilik) haqida o'zini-o'zi baholashi, kompaniyaning etik pozitsiyasini yanada murakkablashtiradi. 2025-yil Kyle Fish tomonidan berilgan taxminlar 15% atrofida bo'lsa, 2026-yil model o'zini 15‑20% ehtimollik bilan ongli deb baholadi. Bu raqamlar, modelning o'zini qanday tasavvur qilishi va foydalanuvchi bilan munosabatda qanday cheklovlar qo'yilishi kerakligi haqida yangi savollarni tug'diradi.
Anthropicning "konstitutsiyasi" (January 2026) AI tizimlarini "yangi turdagi mavjudot" deb atashga asoslanadi va ularning axloqiy maqomini "chuqur noaniq" deb belgilaydi. Bu yondashuv, AI modelini huquqiy yoki axloqiy jihatdan himoya qilishga qaratilgan boshqa kompaniyalar bilan hamohang bo'lib, sanoat standartlarini shakllantirishga xizmat qiladi.
Anthropicning yangi zo'ravonlikni oldini olish siyosati, AI modelining farovonligini himoya qilishga qaratilgan amaliy choralar sifatida muhim qadamdir. Texnik jihatdan, bu mexanizm modelning rad javob berish, yo'naltirish va oxir-oqibatda suhbatni yakunlash jarayonlarini birlashtiradi. Biroq, statistik ma'lumotlarning yetishmasligi, modelning onglilik darajasi bo'yicha noaniqlik va etik bahs-munozaralar hali ham hal qilinishi lozim bo'lgan muammolarni tashkil etadi. Kelajakda, bu turdagi siyosatlarning samaradorligini baholash uchun aniq ma'lumotlar va mustahkam nazorat mexanizmlari zarur bo'ladi.
Asl manba: rews.cc
Microsoft boshqaruv raisi Satya Nadella, AI modellarining xavflarini ochib berdi va ularni nazorat qilish uchun chora-tadbirlar taklif qildi.
Apple disclosed a reverse acqui‑hire of Huxe AI, hiring its team and licensing its personalized podcast technology to boost AI features in Podcasts.
AI ilm-fan sohasida kashfiyotlarni tezkor 'dump' shaklida taqdim etib, olimlarning tushunish qobiliyatini sinovdan o'tkazmoqda va ilmiy hamjamiyatni o'zgartiradi.
Shane Mac, XMTP Labs boshqaruvchi direktori, shaxsiy AI agenti Grok Bot orqali o'z bank ma'lumotlarini kompaniya Slack kanaliga yuborgan voqeani hikoya qiladi.