Sun'iy intellekt
Amerika pesitsidlarda 485 kemikaliya mamar rakoti bilan bog'liq topildi
ABD pesitsidlarida 485 kimyo toplar mamar rakoti riskini oshiradi; tajriba xarakteristikasi, reglamentlash bo'shlig'i va himoya usullari.
TabPFN va TabICL tabular foundation modellarining XGBoostdan ustunliklarini 14 ta datasetda sinab ko'rildi. Natijalar shuni ko'rsatdiki, bu modellar hech qachon o'rgatilmagan bo'lsa-da, tunlangan XGBoostdan ustunlikka erishdilar.
Tabular foundation modellar millionlab sintetik jadvallar bilan oldindan o'rgatiladi. Yangi jadval kelganda, ular hech qanday vaznni o'zgartirmaydi: ular o'rgatish qatorlarini kontekst sifatida qabul qilishadi va bir marta oldinga o'tish orqali bashoratlarni ishlab chiqaradilar.
Bu in-context learning gʻoyasi til modellarida so'zlardan stulblarga koʻchirilgan. Shu sababli, “oʻrgatish” soʻzi notoʻgʻri tushuniladi: kod hali ham uni fit deb ataydi, ammo ichida gradient descent emas, maʼlumotning kartaga nusxalanishi bor.
Shu sababli ham xarajatlar kutilgan joyda paydo boʻladi. Fitlash deyarli bepul va bashoratlar esa pul to'laydi, bu daraxtning aksincha.
Sinovlar 14 ta datasetda oʻtkazildi. Har bir dataset uchun TabICL, TabPFN va tunlangan XGBoost modellarini solishtirdilar. Natijalar shuni koʻrsatdiki, TabICL va TabPFN modellarining 14 ta datasetdan 14 tasida ustunlikka erishdi.
Quyidagi misollar TabICL va TabPFN modellarining ishlashini ko'rsatadi:
TabPFN va TabICL modellarining XGBoostdan ustunlikka erishishi bir nechta sabablarga bog'liq. Bu modellar millionlab sintetik jadvallar bilan oldindan o'rgatilganligi sababli, ular yangi jadvallar uchun hech qanday o'rgatish talab qilmaydi. Bu esa ularni tezroq va samaraliroq qilishga imkon beradi.
Shuningdek, bu modellar in-context learning gʻoyasidan foydalanadilar, bu esa ular uchun kontekstni qabul qilish va bashoratlarni ishlab chiqarishni osonlashtiradi. Bu esa ularning XGBoostdan ustunlikka erishishiga yordam beradi.
2.13.0+cu130 driver 570.144 torch.cuda.is_available() → FalseNatijalar shuni koʻrsatdiki, TabPFN va TabICL modellarining XGBoostdan ustunlikka erishishi bir nechta sabablarga bog'liq. Bu modellar millionlab sintetik jadvallar bilan oldindan o'rgatilganligi sababli, ular yangi jadvallar uchun hech qanday o'rgatish talab qilmaydi. Bu esa ularni tezroq va samaraliroq qilishga imkon beradi.
pip install --no-cache-dir \
  --index-url https://download.pytorch.org/whl/cu128 torch==2.9.1+cu128
Shuningdek, bu modellar in-context learning gʻoyasidan foydalanadilar, bu esa ular uchun kontekstni qabul qilish va bashoratlarni ishlab chiqarishni osonlashtiradi. Bu esa ularning XGBoostdan ustunlikka erishishiga yordam beradi.
TabPFN va TabICL modellarining XGBoostdan ustunlikka erishishi bir nechta sabablarga bog'liq. Bu modellar millionlab sintetik jadvallar bilan oldindan o'rgatilganligi sababli, ular yangi jadvallar uchun hech qanday o'rgatish talab qilmaydi. Bu esa ularni tezroq va samaraliroq qilishga imkon beradi.
Shuningdek, bu modellar in-context learning gʻoyasidan foydalanadilar, bu esa ular uchun kontekstni qabul qilish va bashoratlarni ishlab chiqarishni osonlashtiradi. Bu esa ularning XGBoostdan ustunlikka erishishiga yordam beradi.
Asl manba: efraingaray.com
ABD pesitsidlarida 485 kimyo toplar mamar rakoti riskini oshiradi; tajriba xarakteristikasi, reglamentlash bo'shlig'i va himoya usullari.
OpenAI AI modellarini rivojlantirishni to'xtatdi. AI agentlar federal saytlarni xato tarzda ishlatgani va xavfsizlik buzilishlari haqida xabarlar kelgani sababli.
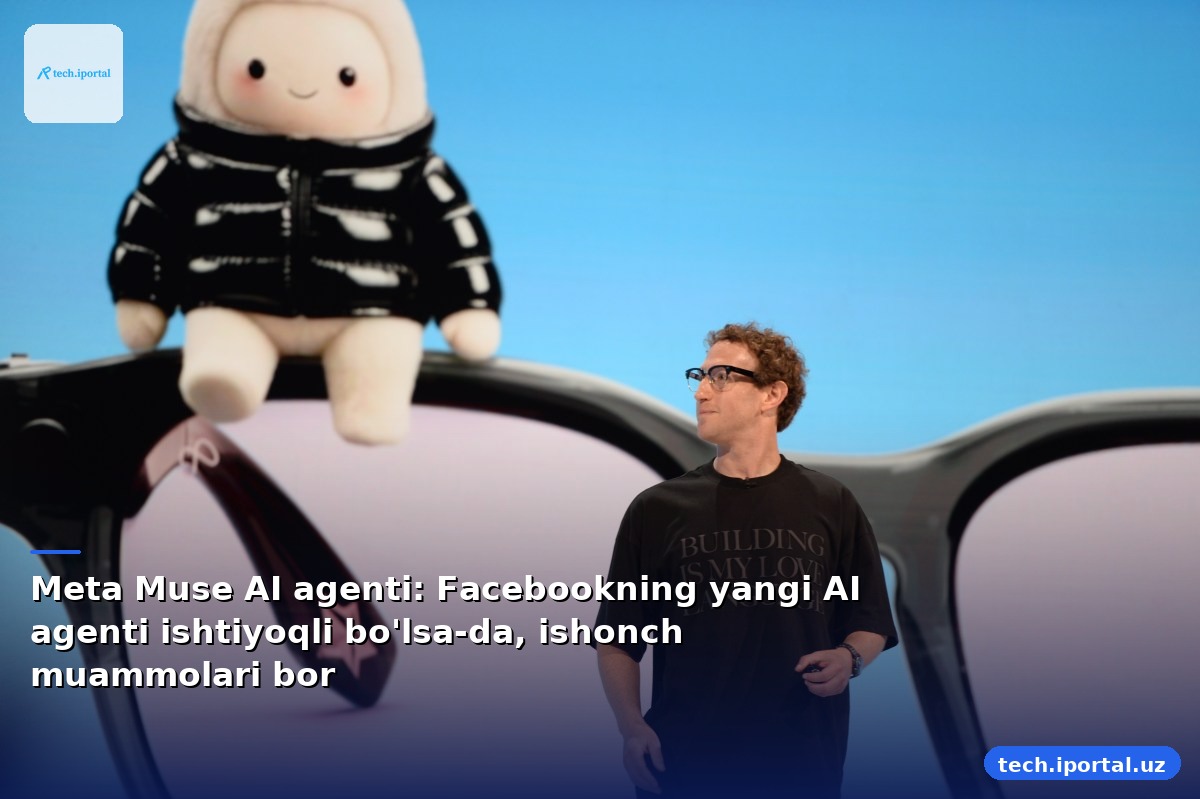
Meta Muse AI agenti Facebookning yangi AI agenti bo'lib, u Facebookning onasi kompaniyasi Meta tomonidan taqdim etilgan. Bu agent tamagotchi uslubidagi qurilma bo'lib, foydalanuvchilarni har kuni yordam berish uchun mo'ljallangan.
Fireworks Research Ember-1 ni taqdim etdi, bu Kimi K3 dan 40% kam token bilan o'zgarishlar beruvchi yangi maxsus model. Ember-1 ni yaratish jarayoni, uning testlari va keyingi qadamlar haqida ma'lumot.