Qwen3.8-27B modeli GVS5H harness yordamida Claude Fable 5 modelini LiveCodeBench Hard testlarida ortda qoldirdi. Bu yangi usul yordamida kodlashtirish samaradorligi oshirildi.
Qwen3.8-27B Modeli Nima?
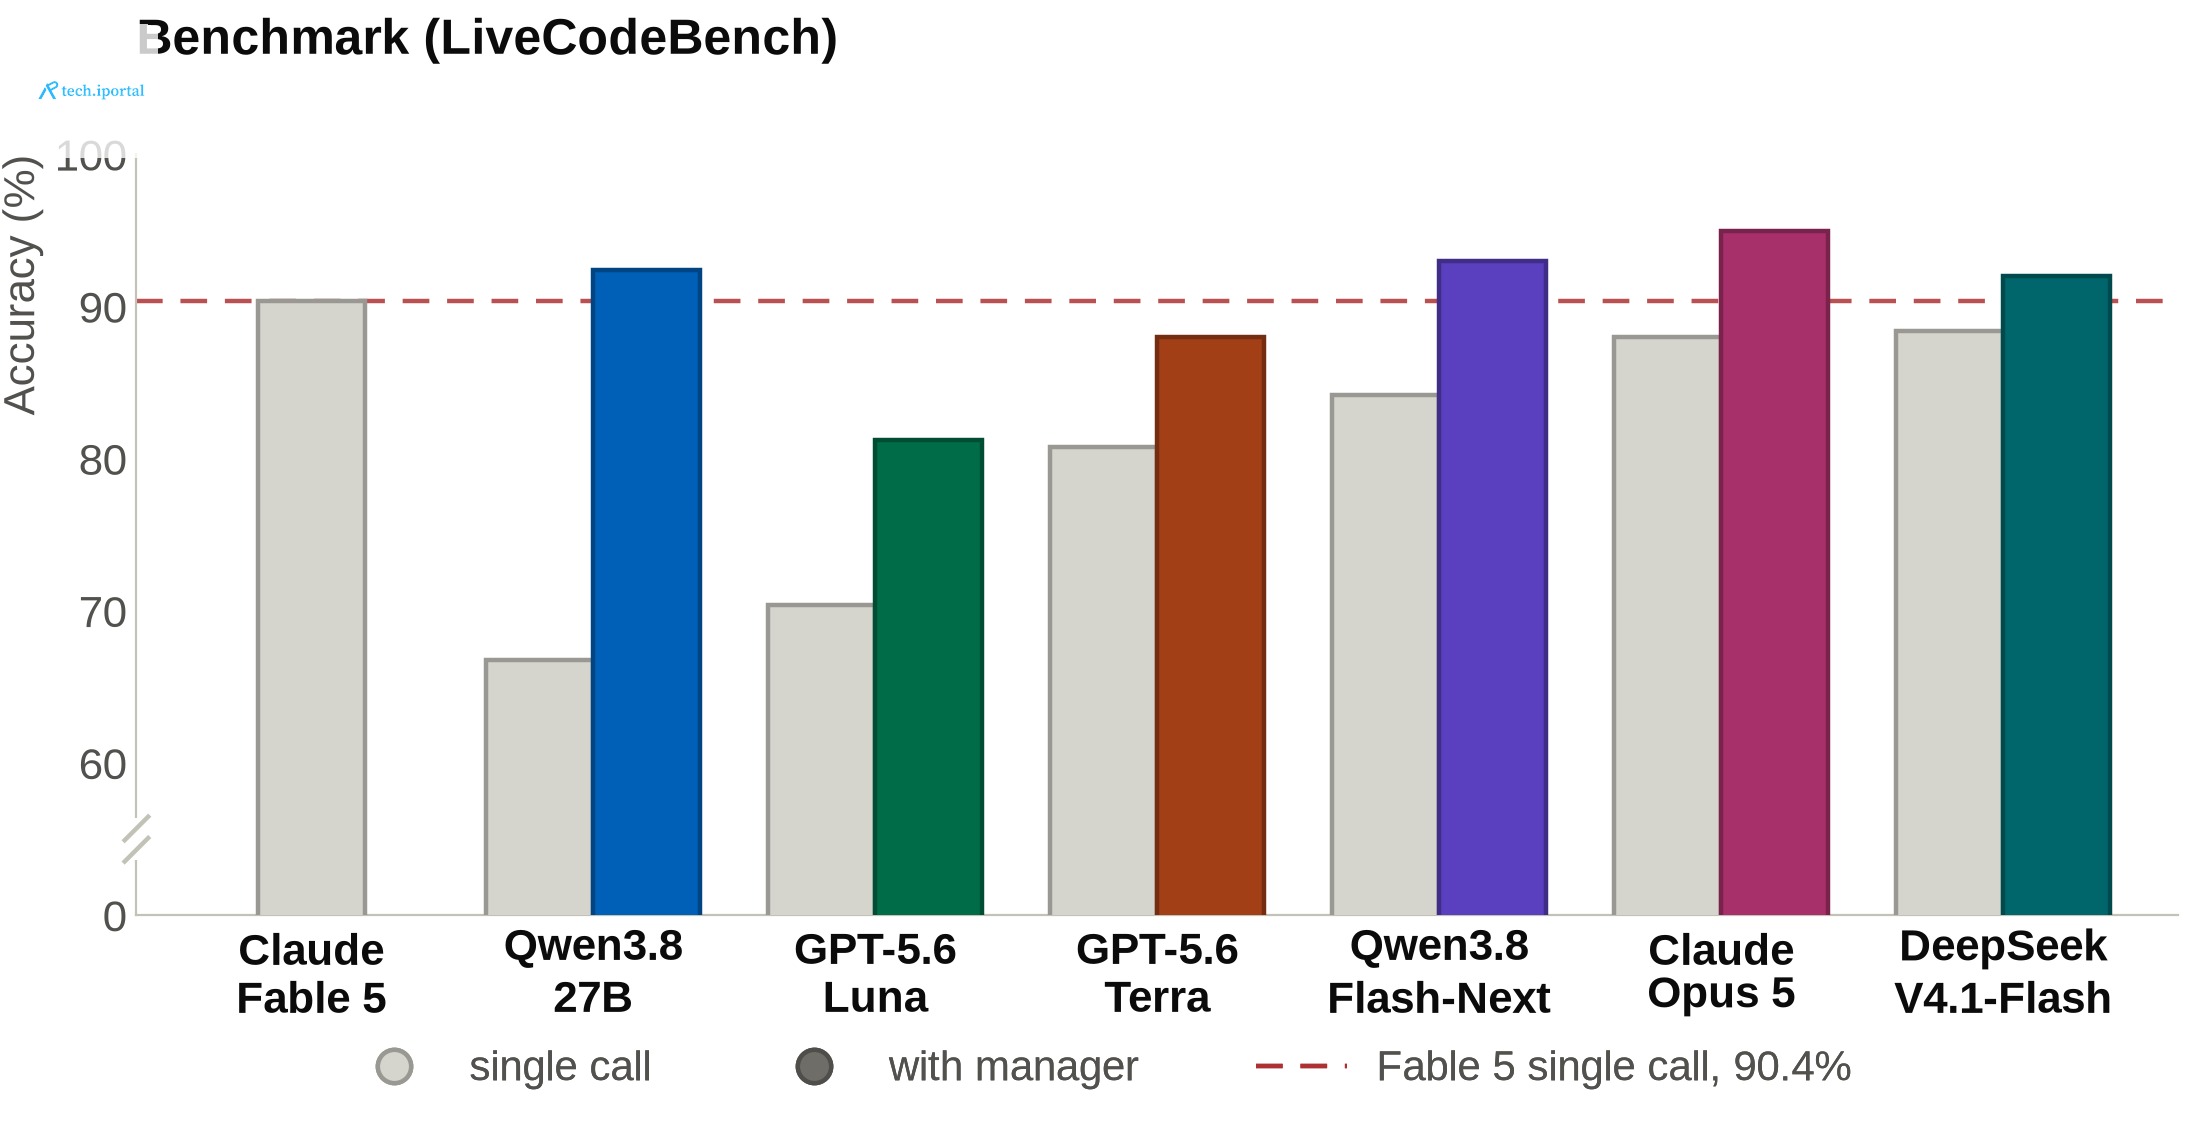
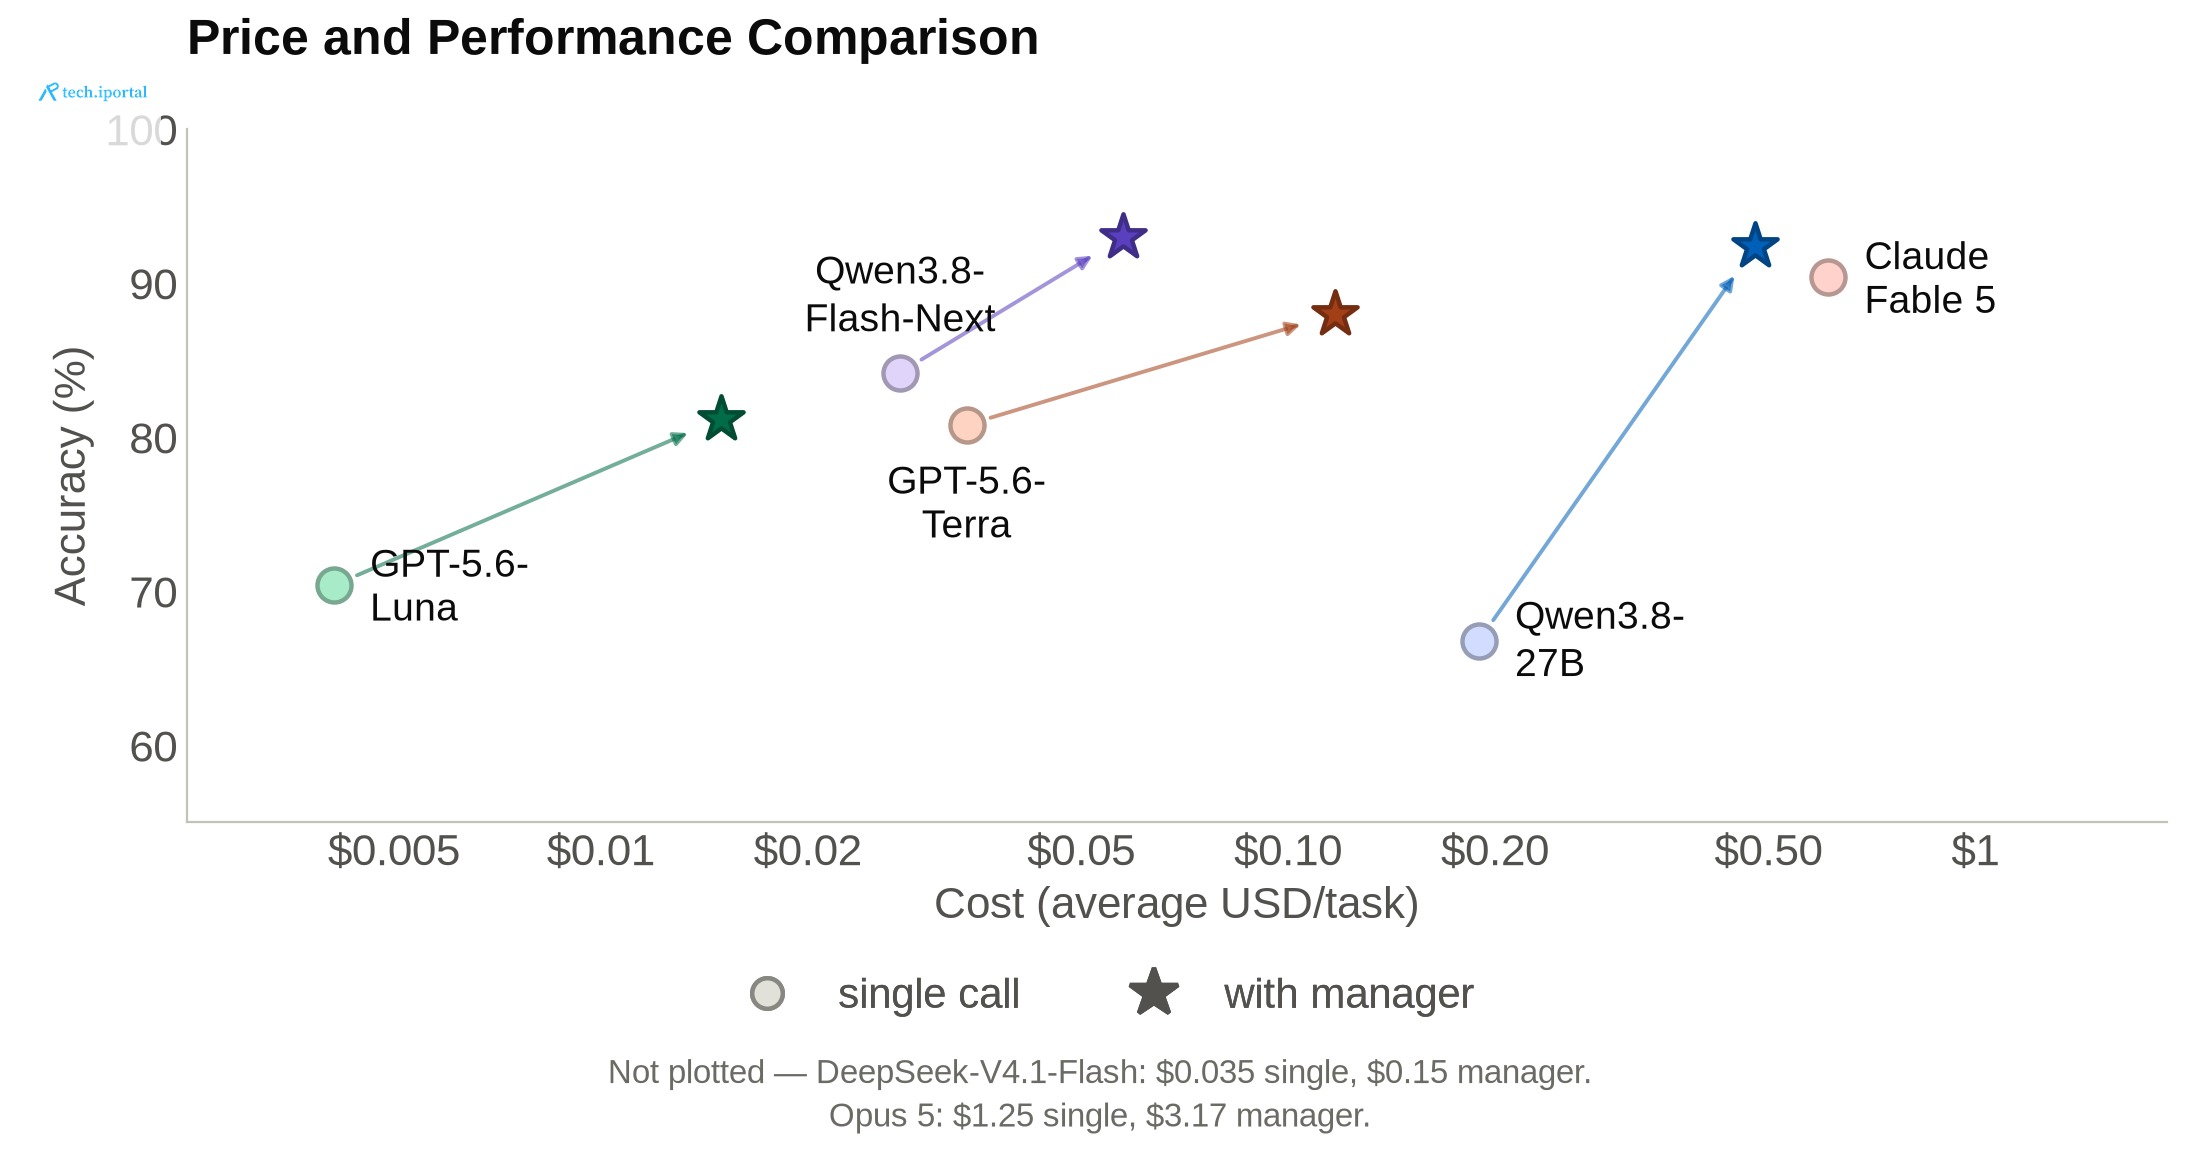
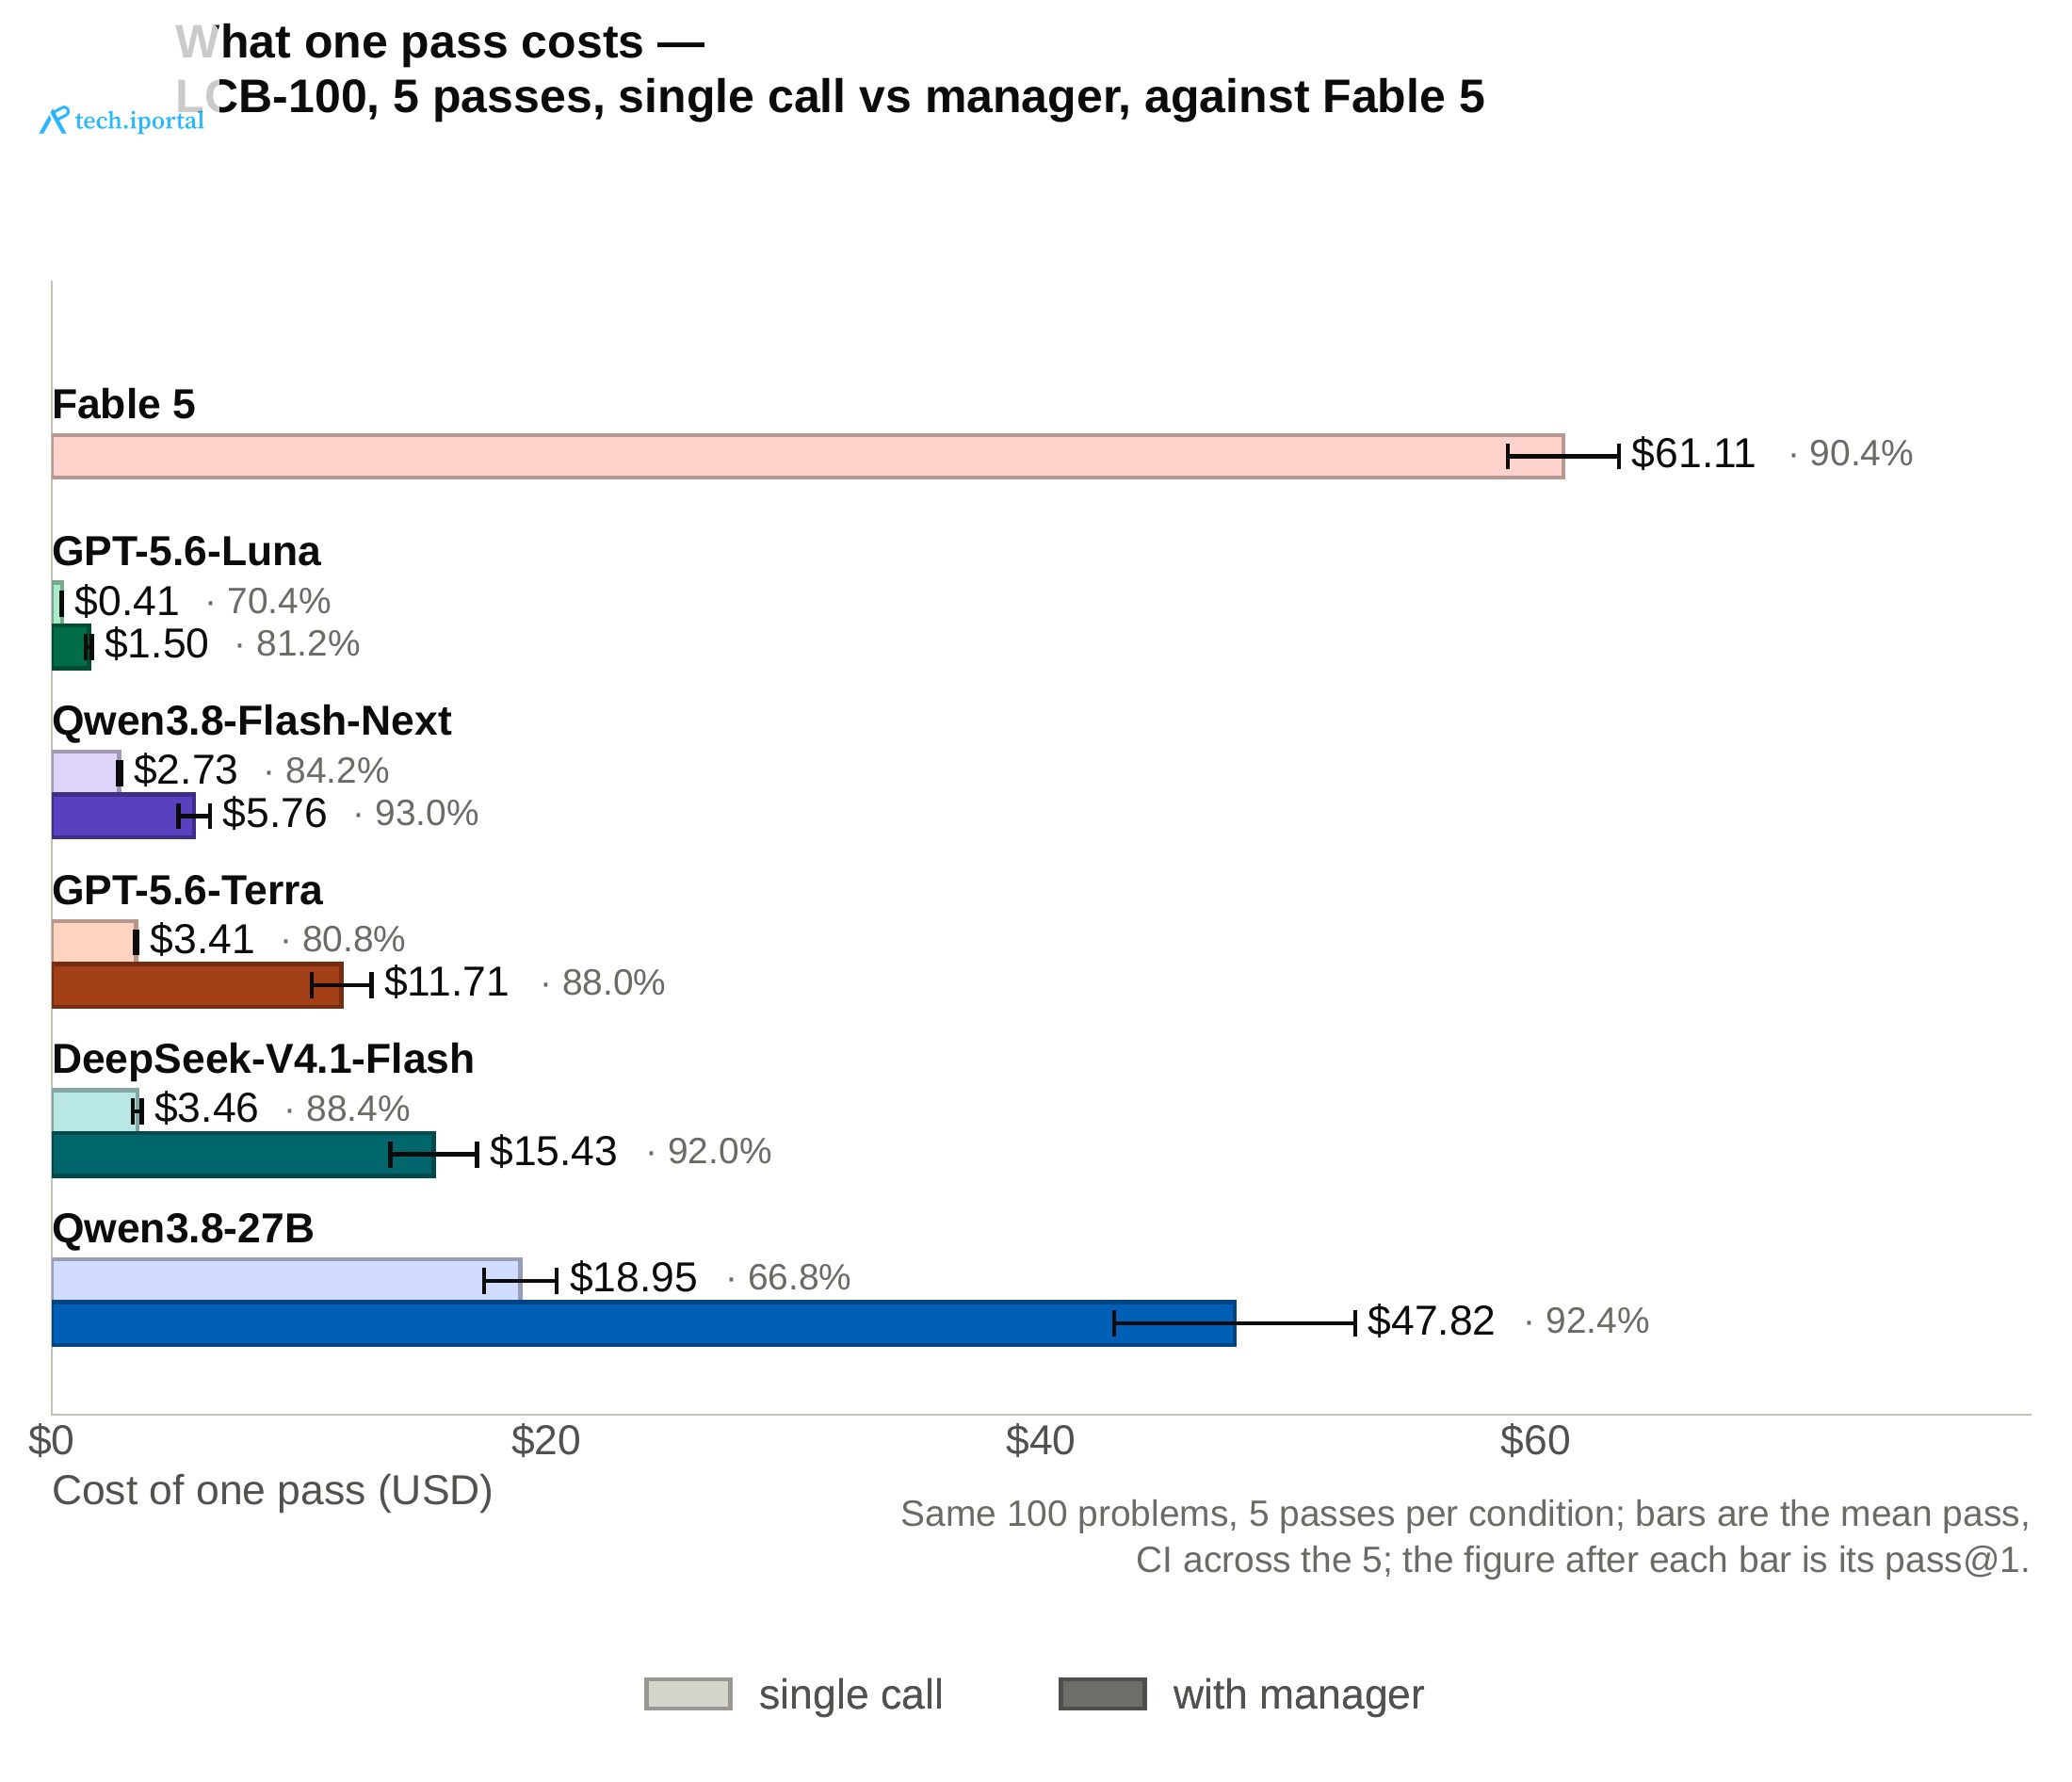
Qwen3.8-27B modeli — bu yuksak intellektli model bo'lib, u GVS5H harness yordamida LiveCodeBench Hard testlarida Claude Fable 5 modelini ortda qoldirdi. Bu modelning samaradorligi 92.4% pass@1 natijaga erishdi, bu esa Fable 5 modelining 90.4% natijasidan yuqori.
GVS5H Harness Nima?
GVS5H harness — bu ledger-based zero-shot self-orchestration usuli bo'lib, bu usul yordamida model muammolarni parchalariga bo'lib, ularni birgalikda hal qilishga qodir. Bu usul yordamida modelning samaradorligi 25.6 foizga oshirildi.
Natijalar
Qwen3.8-27B modeli GVS5H harness yordamida 11 ta ochiq va yopiq og'irlikli modelni LiveCodeBench Hard testlarida sinab ko'rdi. Natijalar shuni ko'rsatdiki, bu model 92.4% pass@1 natijaga erishdi, bu esa Fable 5 modelining 90.4% natijasidan yuqori.
Qanday Ishlaydi?
GVS5H harness yordamida model muammolarni parchalariga bo'lib, ularni birgalikda hal qilishga qodir. Bu usul yordamida modelning samaradorligi 25.6 foizga oshirildi. Model muammolarni parchalariga bo'lib, ularni birgalikda hal qilish uchun umumiy fayl tizimini ishlatadi, bu esa modelning samaradorligini oshirishga yordam beradi.
Qanday Natijalarni Beradi?
Qwen3.8-27B modeli GVS5H harness yordamida 11 ta ochiq va yopiq og'irlikli modelni LiveCodeBench Hard testlarida sinab ko'rdi. Natijalar shuni ko'rsatdiki, bu model 92.4% pass@1 natijaga erishdi, bu esa Fable 5 modelining 90.4% natijasidan yuqori. Bu natijalar shuni ko'rsatdiki, GVS5H harness yordamida modelning samaradorligi 25.6 foizga oshirildi.
cd codebase/v2-current
export OPENAI_API_KEY=...

LCB_RELEASE=release_v6 \
ESCALATION_CLOUD_MAX_TOKENS=128000 \
ESCALATION_CLOUD_TIMEOUT=7200 \
MULTIAGENT_MODEL=openai:gpt-5.6-terra \
uv run --no-project --python 3.12 --with 'datasets<4' --with numpy --with anthropic \
  python escalation/run_bench.py --engine multiagent --only lcb --lcb 100 --parallel 8
Cheklovlar
Barcha model natijalarida oshish bo'lmaydi. Ba'zilarida hech qanday o'zgarish bo'lmaydi yoki hatto natijalar yomonlashishi mumkin. Natijalarni tahlil qilish shuni ko'rsatdiki, samaradorlikning oshishi muammolarni parchalariga bo'lish va doimiy kontekstga bog'liq.
Yakun
Qwen3.8-27B modeli GVS5H harness yordamida Claude Fable 5 modelini LiveCodeBench Hard testlarida ortda qoldirdi. Bu yangi usul yordamida kodlashtirish samaradorligi oshirildi. Bu natijalar shuni ko'rsatdiki, GVS5H harness yordamida modelning samaradorligi 25.6 foizga oshirildi.
Asl manba: github.com