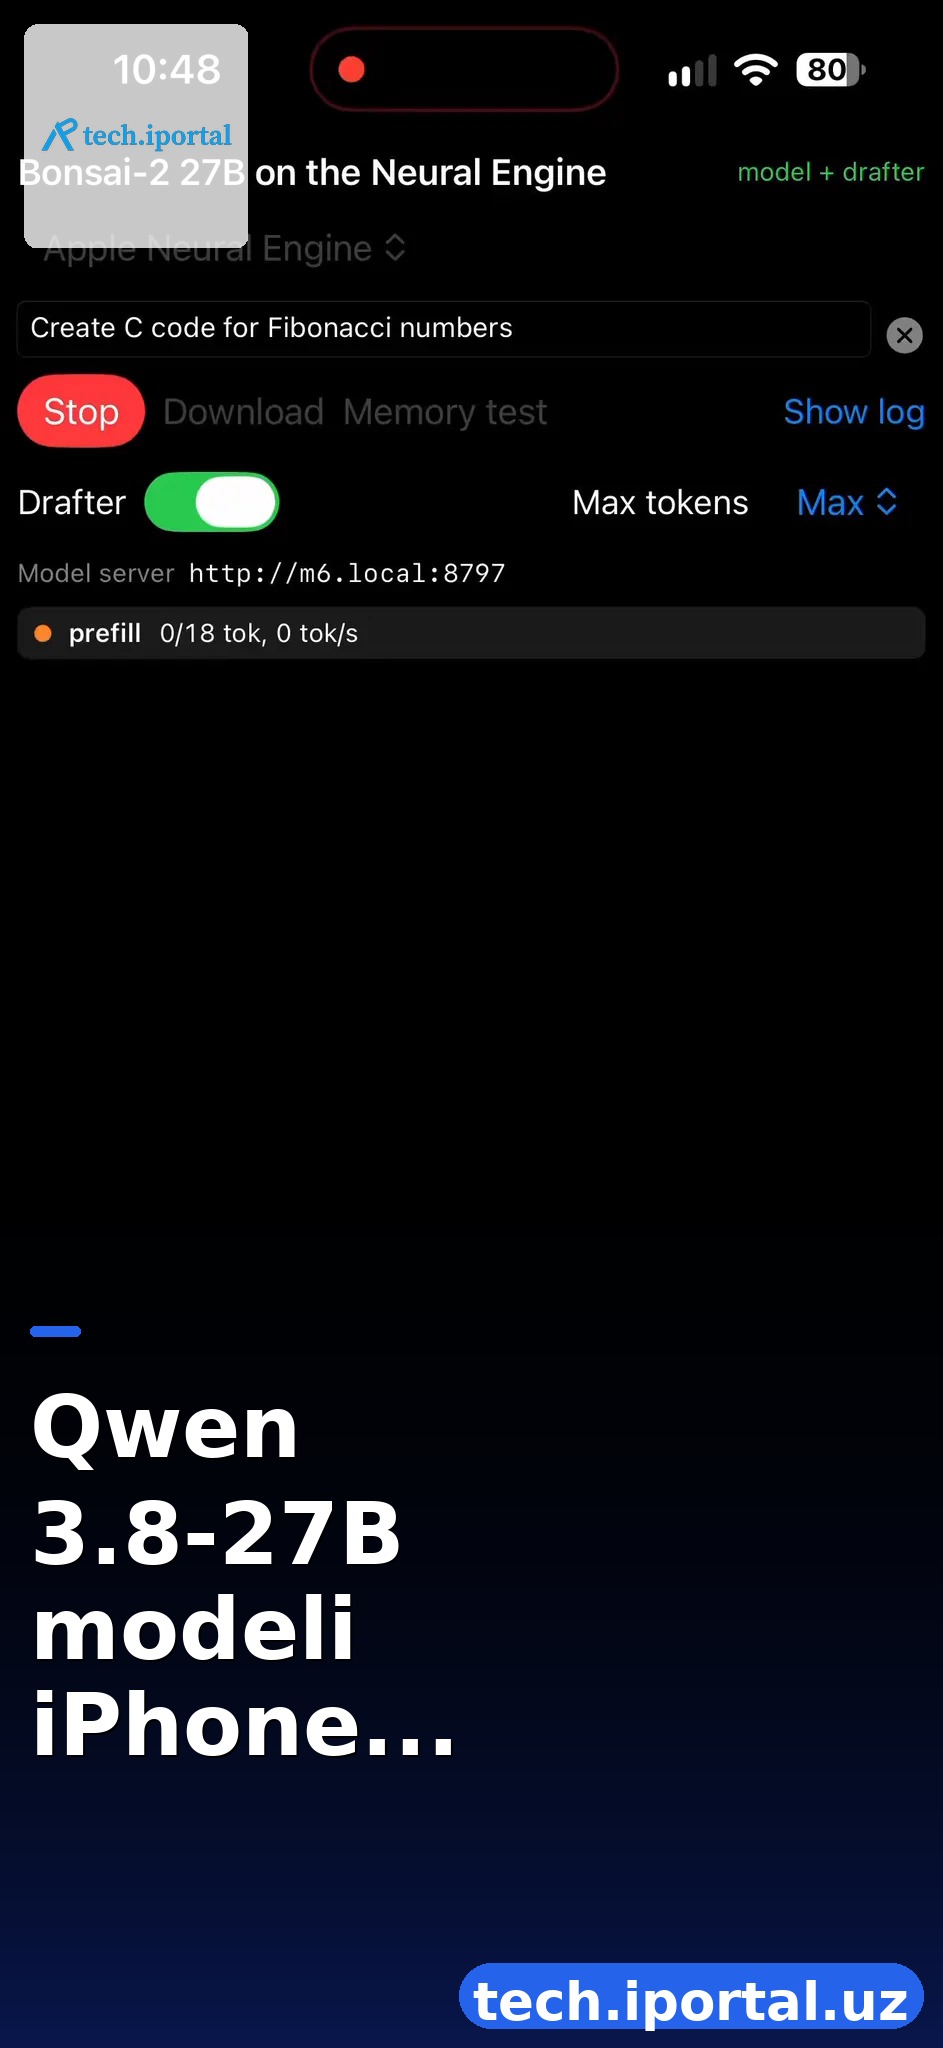
Apple kompaniyasining iPhone 18 seriyasida joylashgan Neural Engine (NE) so‘nggi yillarda sun‘iy intellekt (AI) ish faoliyatini mobil qurilmalarga olib kelish bo‘yicha muhim platformaga aylandi. So‘nggi yangiliklarda, Qwen 3.8‑27B kabi katta til modellari bu NE orqali ishlashga muvaffaq bo‘ldi, 24 000 tokenli kontekst uzunligi va 70 token/soniya dekoding tezligi kabi ko‘rsatkichlar e’lon qilindi. Ushbu maqola, ushbu texnik yutuqning ortidagi texnologik asoslarni, avvalgi yondashuvlar bilan taqqoslashni, cheklovlarni hamda foydalanuvchi hamda sanoatga ta’sirini chuqur tahlil qiladi.
Neural Engine va mobil AI ekotizimi
Apple Neural Engine, A20 chipida joylashgan maxsus hisoblash blokidir. U asosan matritsalar va vektor operatsiyalarini tezlashtirish uchun mo‘ljallangan, shu bilan birga energiya samaradorligini ham saqlaydi. NE ning avvalgi avlodlari BERT yoki MobileBERT kabi kichik modellarga mo‘ljallangan bo‘lsa, iPhone 18‑da NE 27 milliard parametrli Qwen 3.8‑27B modelini ham qo‘llab‑quvvatlay oladi.
Kontekst uzunligi va int8 kvantizatsiya
Qwen 3.8‑27B modeli iPhone’da int8 formatida key‑value (K/V) cache’ini saqlash orqali 24 000 tokenli kontekstga erishdi. Int8 kvantizatsiya, har bir vaznni 8‑bitga qisqartirishni anglatadi, bu esa xotira talablari va hisoblash yukini sezilarli darajada kamaytiradi. Natijada, NE 24 K tokenli matnni bir vaqtning o‘zida qayta ishlashga qodir bo‘ldi, bu esa uzun hujjatlarni, kod bazalarini yoki ilmiy maqolalarni mobil qurilmada tahlil qilish imkonini beradi.
Delta net va FP16 saqlash
Modelning delta net komponenti FP16 (16‑bit floating point) formatida saqlanadi. Bu yondashuv, int8 kvantizatsiyadan farqli o‘laroq, ba’zi qatlamlarda yuqori aniqlikni saqlashga yordam beradi. Delta net asosan modelning noaniq qismida, ya’ni kontekstga moslashuvchanlikni oshiruvchi qatlamlarda ishlatiladi. FP16 saqlash, NE ning yuqori parallelizm imkoniyatlari bilan birgalikda, umumiy ish faoliyatini barqaror qiladi.
Yangi dflash‑2 draft modeli
Qwen 3.8‑27B ning dflash‑2 draft varianti ham sinovdan o‘tkazildi. Bu versiyada 2‑4 vektor kvantizatsiyasi qo‘llanilib, har bir 4 ta vazn uchun 6‑bit vektor kodlari ishlatiladi. Natijada, model 2.8 bpw (bit per weight) darajasiga qisqaradi, lekin qabul qilish darajasida (acceptance rate) kichik pasayish kuzatiladi. Bu yondashuv, mobil qurilmalar uchun yanada ixcham model yaratishga qaratilgan, ammo aniqlikni saqlash uchun muvozanatni talab qiladi.
Dekoding tezligi: 15‑70 token/soniya
iPhone 18 NE’da dekoding tezligi 15‑60 token/soniya oralig‘ida, eng qulay kontekstda esa 70 token/soniya gacha yetadi. Bu ko‘rsatkich, ayniqsa real‑vaqt chat‑botlar, kod tavsifi yoki matn generatsiyasi uchun muhim. Oldingi mobil AI yondashuvlari, masalan, Apple‑ning Core ML asosidagi kichik transformerlar, odatda 5‑15 token/soniya tezlikda ishlagan. Shuning uchun, Qwen 3.8‑27B ning bu natijasi, mobil AI ning yangi bosqichini belgilaydi.
Taqqoslash: Desktop GPU vs. iPhone NE
Desktop GPU’larda, masalan, NVIDIA RTX 4090’da, Qwen 3.8‑27B modeli 200‑300 token/soniya tezlikda ishlashi mumkin. Biroq, mobil qurilmada shu darajadagi ish faoliyatini NE orqali erishish, energiya sarfini ancha kamaytiradi. iPhone 18’da 70 token/soniya dekoding, 10‑15 W quvvat iste’moli bilan amalga oshiriladi, bu esa laptop yoki desktopga nisbatan 5‑10 baravar kam. Bu farq, foydalanuvchilarga offline, doimiy internetga ulanmasdan AI xizmatlarini taqdim etish imkonini beradi.
Cheklovlar va ochiq savollar
- Xotira chegaralari: 24 K token kontekst int8 K/V cache’ini talab qiladi, bu esa iPhone‑ning RAM hajmi bilan chegaralanadi. Katta kontekstda bir nechta ilovalar birga ishlaganda, xotira yetishmasligi muammosi yuzaga kelishi mumkin.
- Model aniqligi: Int8 kvantizatsiya va dflash‑2 draft modeli ba’zi noaniq vazifalarda aniqlik pasayishini keltirib chiqaradi. Bu, maxsus ilmiy yoki tibbiy matnlar uchun qo‘shimcha tekshirishni talab qiladi.
- Yuklanish va yangilash: Modelni iPhone’ga yuklash jarayoni, Apple‑ning on‑device model deployment jarayoniga bog‘liq. Yangi versiyalarni tezda tarqatish uchun Apple‑ning Core ML va Model Deployment API’lari yanada soddalashtirilishi kerak.
- Energiya samaradorligi: NE juda samarali bo‘lsa-da, uzoq muddatli ishlashda batareya hayoti qanday ta’sirlanadi, bu haqda batafsil ma’lumotlar hali ochiq emas.
Kimga va qanday ta’sir qiladi?
Bu yutuq bir necha foydalanuvchi guruhiga bevosita foyda keltiradi:
- Mobil dasturchilar: Ular o‘z ilovalarida katta til modellari asosida matn generatsiyasi, kod tavsifi yoki avtomatik tarjima funksiyalarini qo‘shishlari mumkin.
- Biznes foydalanuvchilar: Kichik korxonalar, katta server infratuzilmasiga sarmoya kiritmasdan, iPhone‑lar orqali AI‑assistentlar, mijozlarga xizmat ko‘rsatish botlari yoki ma’lumot tahlili vositalarini yaratishlari mumkin.
- Ilmiy hamjamiyat: Uzoq matnli ilmiy maqolalar, ma’lumotlar bazalari yoki kod bazalarini mobil qurilmada tahlil qilish imkoniyati, tadqiqot ishlarini yanada samarali qiladi.
Shuningdek, Apple ekotizimida AI xizmatlari yanada mustahkamlanadi, bu esa raqobatchilarga nisbatan foydalanuvchi sodiqligini oshiradi.
Kelajakda nima kutish mumkin?
Apple Neural Engine’ning keyingi avlodlari, yanada ko‘proq tensor yadro va yuqori xotira kengaytmasi bilan, 100 token/soniya darajasiga yetishi kutilmoqda. Bundan tashqari, Apple‑ning on‑device training imkoniyatlari ham rivojlanadi, bu esa foydalanuvchi ma’lumotlariga asoslangan shaxsiylashtirilgan modellarning yaratishiga yo‘l ochadi. Qwen 3.8‑27B kabi katta modellarning mobil platformalarda muvaffaqiyati, kelajakda yanada kichik, lekin samarali arxitekturalar, masalan, Mixture‑of‑Experts (MoE) yondashuvlari ham qo‘llanilishini ko‘rsatadi.
Umuman olganda, iPhone 18 Neural Engine’da Qwen 3.8‑27B modelining 24 K kontekst va 70 tok/s dekoding ko‘rsatkichlari, mobil AI texnologiyasining yangi bosqichini belgilaydi. Bu yutuq, nafaqat foydalanuvchi tajribasini yaxshilaydi, balki AI xizmatlarini kengroq auditoriyaga yetkazish uchun infratuzilma imkoniyatlarini ham kengaytiradi.
Manba: Twitter post
Asl manba: twitter.com