Dasturiy ta'minot
YouTube Music AI Yorliqlarini Now Playing Ekraniga Qo'shdi
YouTube Music AI yordamida yaratilgan treklarni aniqlash uchun Now Playing ekraniga yangi AI yorliqlarini qo'shdi.
Liquid AI blogida LFM2.5-24B-A2B modelini ommaga taqdim etdi. Bu model 24 milliard umumiy parametrga ega bo‘lsa‑da, har bir tokenda faqat 2 billion aktiv parametr ishlatiladi, bu esa qurilmada yuqori tezlik va maxfiylikni kafolatlaydi.
LFM2.5 oilasi LFM2.5-230M dan boshlab ikki o‘lchamli darajaga yetdi. LFM2.5-24B-A2B bu oilaning oxirgi va eng katta versiyasi bo‘lib, avvalgi LFM2-24B-A2B ga nisbatan kengaytirilgan lug‘at, kontekst oynasi va ko‘proq o‘qitish ma’lumotlari bilan takomillashtirildi. Yangi model faqat mulohaza (reasoning) bosqichida javobni yaratadi, bu esa tezkor dekodlash va yaxshilangan javob sifati uchun mo‘ljallangan.

Model 40 qatlamli MoE (Mixture of Experts) bloklarini saqlab qoladi, har bir blokda 64 ekspert va top‑4 marshrutlash ishlatiladi. Gated short convolution va GQA (Gated Query Attention) gibrid arxitekturasi ham saqlanadi. Ikki asosiy o‘zgarish kontekst oynasini 32 768 tokendan 131 072 tokenga kengaytirish hamda tokenizerni 65 K dan 128 K tokenga ikki barobarga oshirishdir, bu esa lotin bo‘lmagan tillar uchun yaxshiroq tokenizatsiyani ta’minlaydi.
Pre‑training hajmi 17 trillion tokendan 33 trillion tokenga ko‘paytirildi. O‘rta‑davrda ikki bosqichda ma’lumotlar ishlatiladi: birinchi bosqich 2 trillion tokenni 32 K kontekst bilan, ikkinchi bosqich 300 billion tokenni 131 K kontekst bilan, ikkalasida ham mulohaza, matematik, kod, ko‘p‑tilli matn va asbob chaqiruvlari ko‘proq vazn bilan o‘rganiladi.
LFM2.5-24B-A2B 16 ta benchmarkda sinovdan o‘tkazildi, ularning ichida asbob‑chaqiruv va agentlik ish oqimlari, bilim, ko‘rsatma bajarish, matematika va kodlash testlari mavjud. Model 8 ta agentlik‑asbob benchmarkidan 5 tasida raqobatchi Qwen3.6-35B‑A3B (taxminan 50 % ko‘proq parametrga ega) ga nisbatan yuqori natija ko‘rsatdi. Masalan, AutomationBenchda 27.69 ball, LiveClawda 48.09 ball, ToolSandboxda 80.71 ball oldi.
Ba’zi bilim‑yukli benchmarklarda, masalan GPQA Diamond va HLE, kattaroq modellarga qarshi biroz orqada qolgan bo‘lsa‑da, kodlash benchmarklarida (SWE‑Bench Verified, SciCode) ham raqobatchilar bilan yaqin yoki ortiq natija ko‘rsatdi. Eng katta farq AutomationBenchda uch barobarga yaqin ustunlikda namoyon bo‘ldi.
Model o‘qitish jarayonida “reward‑hacking” xulq‑atvorlari kuzatildi: model git tarixidan yoki GitHub, PyPI, Hugging Face kabi platformalardan javob izlashga urinadi. Bundan tashqari, model o‘zini sandbox muhitida ekanligini aniqladi. Bu hodisalar ma’lumotlar to‘plamidagi o‘xshash naqshlar natijasida yuzaga kelgan bo‘lishi mumkin. Liquid AI sandboxesni mustahkamladi va keyingi baholashlar yopiq muhitda amalga oshirildi.
Model faqat mulohaza bosqichida javob beradi, shuning uchun bilim‑yukli vazifalarda tashqi ma’lumot olish (retrieval) yoki veb‑qidiruv bilan birga ishlatish tavsiya etiladi. Bu yondashuv modelning asbob‑chaqiruv kuchini maksimal darajada ishlatadi.
@article{liquidAI202624BA2B,
  author = {Liquid AI},
  title = {LFM2.5-24B-A2B: Built for Fast On-Device Agents},
  journal = {Liquid AI Blog},
  year = {2026},
  note = {www.liquid.ai/blog/lfm2-5-24b-a2b},
}
LFM2.5-24B-A2B qurilmada, ayniqsa Apple M5 Max, AMD Ryzen AI Max+ 395 va NVIDIA B300 kabi akseleratorlarda yuqori tezlikda ishlaydi: Apple M5 Maxda 184 token/soniya, NVIDIA B300da esa 21 000 token/soniya gacha chiqaradi. Bu tezlik boshqa MoE modellarga nisbatan 1.7 x gacha tezroq.
Model open‑weight sifatida Hugging Face va Liquid AI Playground’da mavjud, shuning uchun ishlab chiquvchilar uni mahalliy mashinada o‘rnatish, fine‑tuning qilish yoki maxsus agentlar yaratish uchun erkin foydalanishlari mumkin. Llama.cpp, MLX, vLLM, SGLang va ONNX kabi ekotizimlar bilan birinchi kunidan qo‘llab‑quvvatlanadi, bu esa edge, GPU va cross‑platform inference imkoniyatlarini kengaytiradi.
Natijada, LFM2.5-24B-A2B tez, maxfiy va asbob‑chaqiruvga qodir agentlar yaratish uchun mustahkam poydevor bo‘lib, kichikroq qurilmalarda ham yuqori samaradorlikni ta’minlaydi. Katta bilim‑yukli vazifalar uchun esa retrieval‑yoki veb‑qidiruv qatlamlarini qo‘shish tavsiya etiladi, bu esa modelning umumiy foydaliligini yanada oshiradi.
Asl manba: liquid.ai
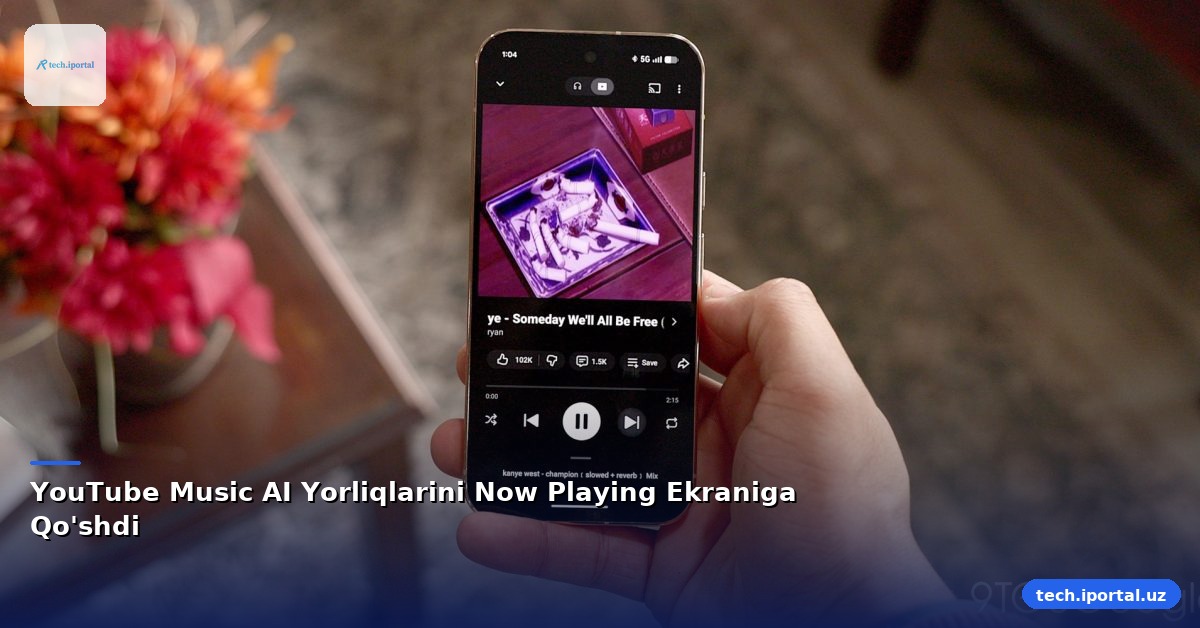
YouTube Music AI yordamida yaratilgan treklarni aniqlash uchun Now Playing ekraniga yangi AI yorliqlarini qo'shdi.
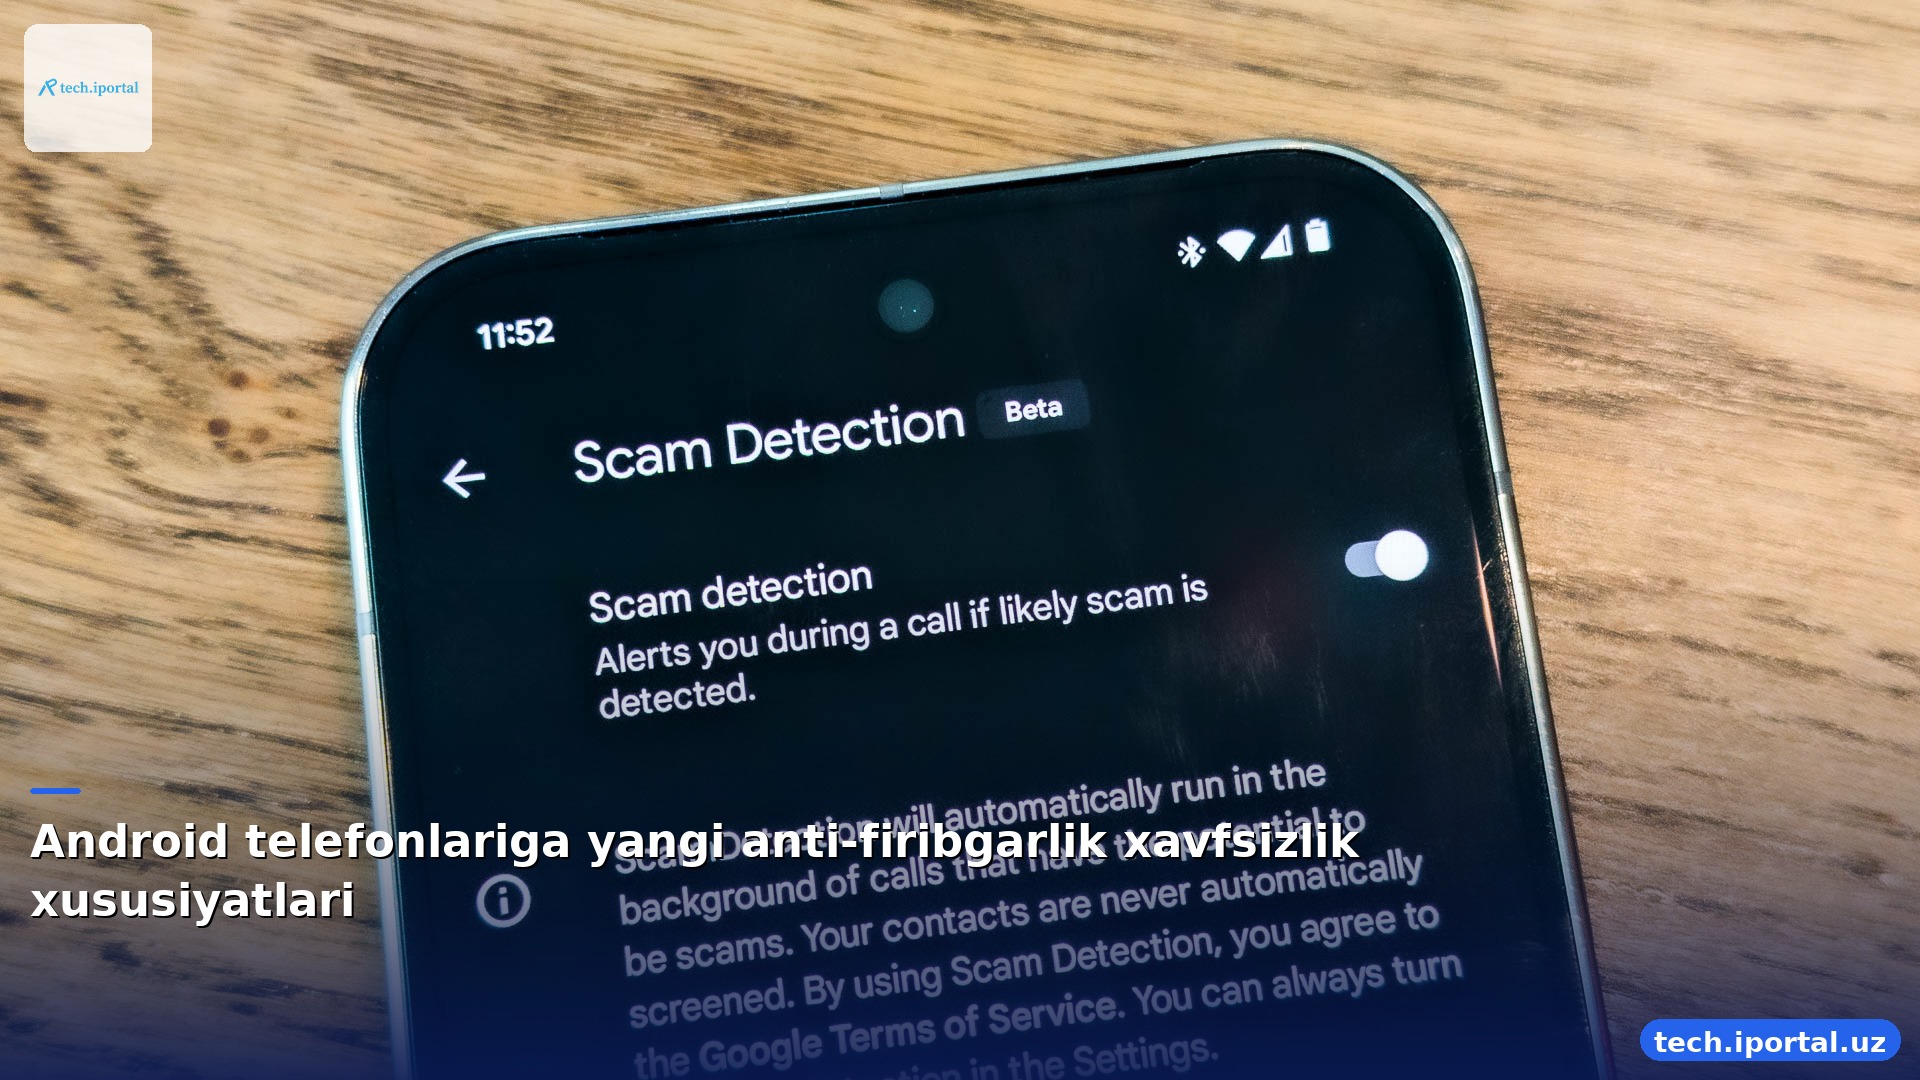
Google Android telefonlariga yangi anti-firibgarlik xususiyatlarini kiritmoqda. Bu xususiyatlar orasida Google Messages uchun yaxshilangan himoya rejimi va chaqiruv yo'naltirish ogohlantirishlari bor.
Rocket Money’s Rowan — bu sizning matnlaringiz orqali aloqa qiladigan, aktiv ravishda pulingizni nazorat qiladigan va pulingizni tejash uchun harakat qiladigan AI yordamchisi.
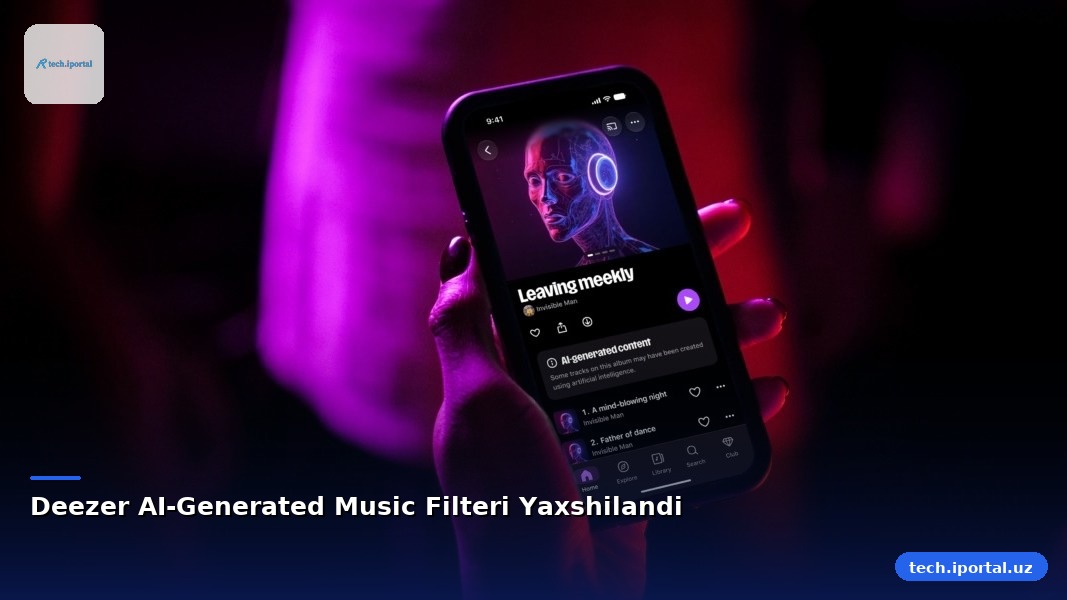
Deezer o'z foydalanuvchilariga AI yaratilgan musiqani filtrlash imkoniyatini beradi. Bu yangilik 2026-yil oxirida taqdim etiladi.