Sun'iy intellekt
LLM Watermarking: Invisible Tags and Their Effect on AI Agent Decisions
LLM watermarking changes token selection, causing refusal drift and tool‑calling errors in AI agents. Study shows practical safety impact.
Yaqinda original maqolada Jev nomli yangi AI modelining tezligi, arzonligi va tiplangan natijalar berish qobiliyati ta'kidlandi. Biroq, bu texnologiyaning amaliy qo'llanilishida yuzaga keladigan ishonchsizlik va baholash muammolari dasturchilar hamjamiyatida keng tarqalgan xavotirga sabab bo'ldi.
Jev TypeSafe AI tomonidan ishlab chiqilgan bo'lib, quyidagi afzalliklarni taklif qiladi:
Bu xususiyatlar, ayniqsa, prototip yaratish bosqichida va tezkor iteratsiyalar talab qilinadigan LLM (large language model) asosidagi loyihalarda jozibador bo'ladi.
Jevning “confidence score”lari foydalanuvchilarga natijaning qanchalik ishonchli ekanligini ko'rsatadi. Amalda esa bu ko'rsatkichlar ko'pincha kalibrlash (calibration) etishmasligi sababli noto'g'ri talqin qilinadi. Model 0.9 baho bilan javob bersa ham, aslida bu baho 70% ishonchlilikni ifodalashi mumkin.
Kalibrlashni amalga oshirish uchun foydalanuvchi quyidagi bosqichlarni bajarishi kerak:
Bu jarayonlar ko'p vaqt va resurs talab qiladi, shuning uchun ko'p kompaniyalar Jevni “qora quti” (black‑box) sifatida ishlatib, baholash bosqichini e'tiborsiz qoldiradi.
Ko'p hollarda ishlab chiquvchilar confidence score’ni “agar 0.9 dan yuqori bo'lsa, harakatni bajar” degan oddiy qoidaga asoslanib qo‘llashadi. Bu yondashuv “cargo cult” deb ataladi, ya'ni texnik asosni tushunmasdan, faqat tashqi ko‘rinishga tayanish.
Natijada:
Jevni an'anaviy REST yoki RPC API‑lari bilan solishtirsak, bir nechta farqlarni ko‘ramiz:
Jevning joriy versiyasida quyidagi cheklovlar mavjud:
Kelajakda quyidagi savollar hal qilinishi kerak:
Jevning tezligi va arzonligi kichik startaplar, prototip ishlab chiquvchilar va LLM‑ga asoslangan mahsulotlarni tezda bozorga chiqarishni istagan kompaniyalar uchun jozibador. Biroq, ishonchlilikni nazorat qilishga e'tibor bermaslik quyidagi guruhlarga zarar yetkazadi:
Shu sababli, Jevni joriy etishda baholash infratuzilmasi va mas'uliyatli monitoring strategiyasini birga yaratish zarur.
Jev kabi AI xizmatlari tezkor innovatsiyalarni qo‘llab‑quvvatlasa ham, ularni “qora quti” sifatida ishlatish xatoliklarni normalizatsiya qilish xavfini tug‘diradi. Dasturchilar va mahsulot menejerlari baholash pipelineni yaratish, confidence score’ni kalibrlash va aniq threshold’larni belgilash orqali “stupid thing sucks” degan umumiy norozilikni ilmiy asosli tahlilga aylantirishlari kerak.
Bu yondashuv nafaqat modelning texnik ishonchliligini oshiradi, balki foydalanuvchi tajribasini yaxshilash, mahsulotga bo‘lgan ishonchni mustahkamlash va AI‑ning “magik” deb ko‘rilishini oldini olishga yordam beradi.
Asl manba: ihatethefuture.com
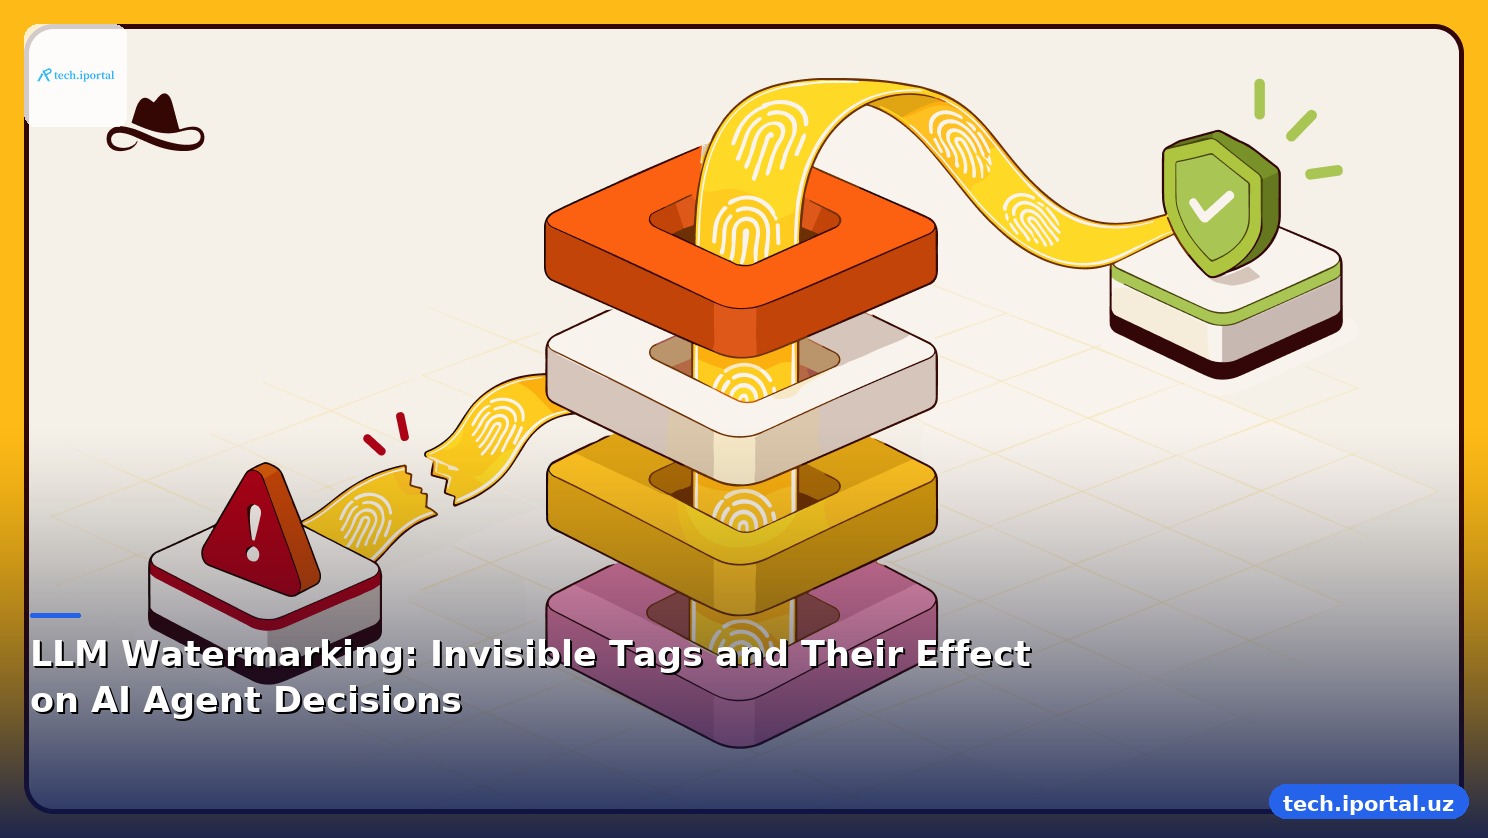
LLM watermarking changes token selection, causing refusal drift and tool‑calling errors in AI agents. Study shows practical safety impact.
Privatemode AI GLM-5.3-Flashni Jev-ga o'xshash qaror modeliga aylantirish usulini taqdim etdi. Bu usul bir martalik o'tkazishda har bir variant uchun ehtimoliyatni aniqlaydi.

AI-native avlodni tarbiyalash va mahalliy AI modellari yaratish bo'yicha ekspertlar besh yillik strategiyani, infratuzilma, startaplar va hamkorlik tavsiyalarini taqdim etdi.
Claude Code skilli shaxmat o‘yinlarini audio izoh bilan tahlil qiladi, Stockfish bilan birgalikda har bir harakatni tushuntiruvchi video post‑mortem yaratadi, o‘yinchilarga chuqur o‘rganish imkonini beradi.