Dasturiy ta'minot
Color OS 17 rollout schedule for OnePlus and realme devices announced
OnePlus and realme reveal official Color OS 17 rollout dates, starting Oct 29 2026 and extending into Q1 2027 for flagship and midrange models.
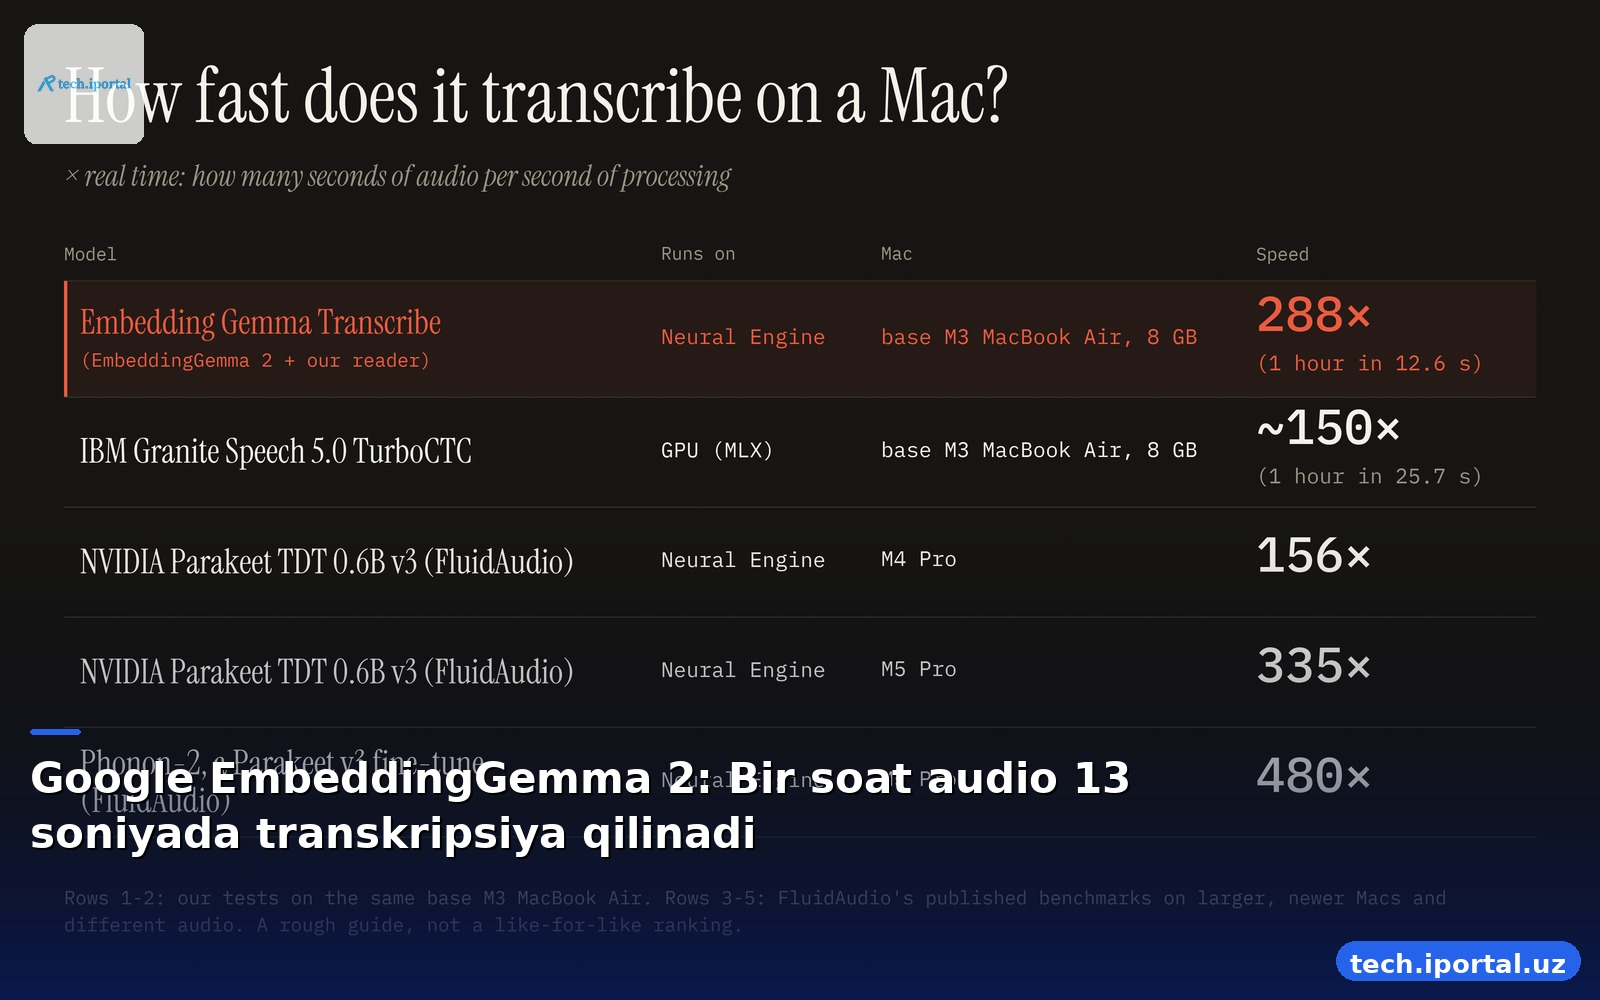
Google EmbeddingGemma 2 modeli bir soatlik audio faylni 13 soniyada transkripsiya qilish imkoniyatiga ega. Bu texnologiya MacBook Air kabi qurilmalarda ishlaydi.
Google EmbeddingGemma 2 — bu multimodal embedding modeli boʻlib, matn, tasvirlar, audio va video maʼlumotlarini bir xil fazoda birlashtiradi. Bu modelni audio transkripsiya qilish uchun ishlatish mumkin. Modelning audio kodlaydigi qism oʻzgarishsiz qoladi, lekin kichik oʻquvchi qism har bir qisqa audio kesimini modelning matn fazosiga koʻchiradi. Eng yaqin 229 mingdan ortiq inglizcha soʻzlardan biriga toʻgʻri keladigan soʻz tanlanadi va audio kesimlari transkripsiyaga aylanadi. Bundan tashqari, kichik qoʻshimcha model belgilar va katta harflarni qoʻshadi.
Modelning oʻquvchi qismi faqat ochiq litsenziyalangan inglizcha nutq maʼlumotlariga asoslanib, taxminan ikki soat davomida 8×H100 qurilmasida oʻrgatiladi. Asosiy model hech qachon nutqdan matnga aylantirish uchun oʻrgatilmagan.
Google EmbeddingGemma Transcribe modeli MacBook Air (base M3, 8 GB) qurilmasida bir soatlik audio faylni 12,6 soniyada transkripsiya qilish imkoniyatiga ega. Bu tezlik IBM Granite Speech 5.0 TurboCTC modelidan ikki baravar tezroqdir.
Bu tezliklar faqat bir xil qurilmalarda oʻtkazilgan sinovlar asosida hisoblangan. Boshqa qurilmalarda tezliklar farq qilishi mumkin.
Bu texnologiya audio faylni tushirish yoki Right Option tugmasini bosib, nutqni yozib olish imkoniyatini beradi. Barcha audio maʼlumotlari qurilmaning Neural Engine-da ishlaydi va qurilma tashqarisiga chiqmaydi.
Hozircha EmbeddingGemma Transcribe modelining soʻz xatosi darajasi taxminan 5% ni tashkil qiladi, bu esa yetakchi nutq modellarining 2-3% xatosidan yuqori. Ammo, modelni yaxshiroq oʻrgatish orqali bu xatolarni kamaytirish mumkin.
Asl manba: eg2.haku.sh
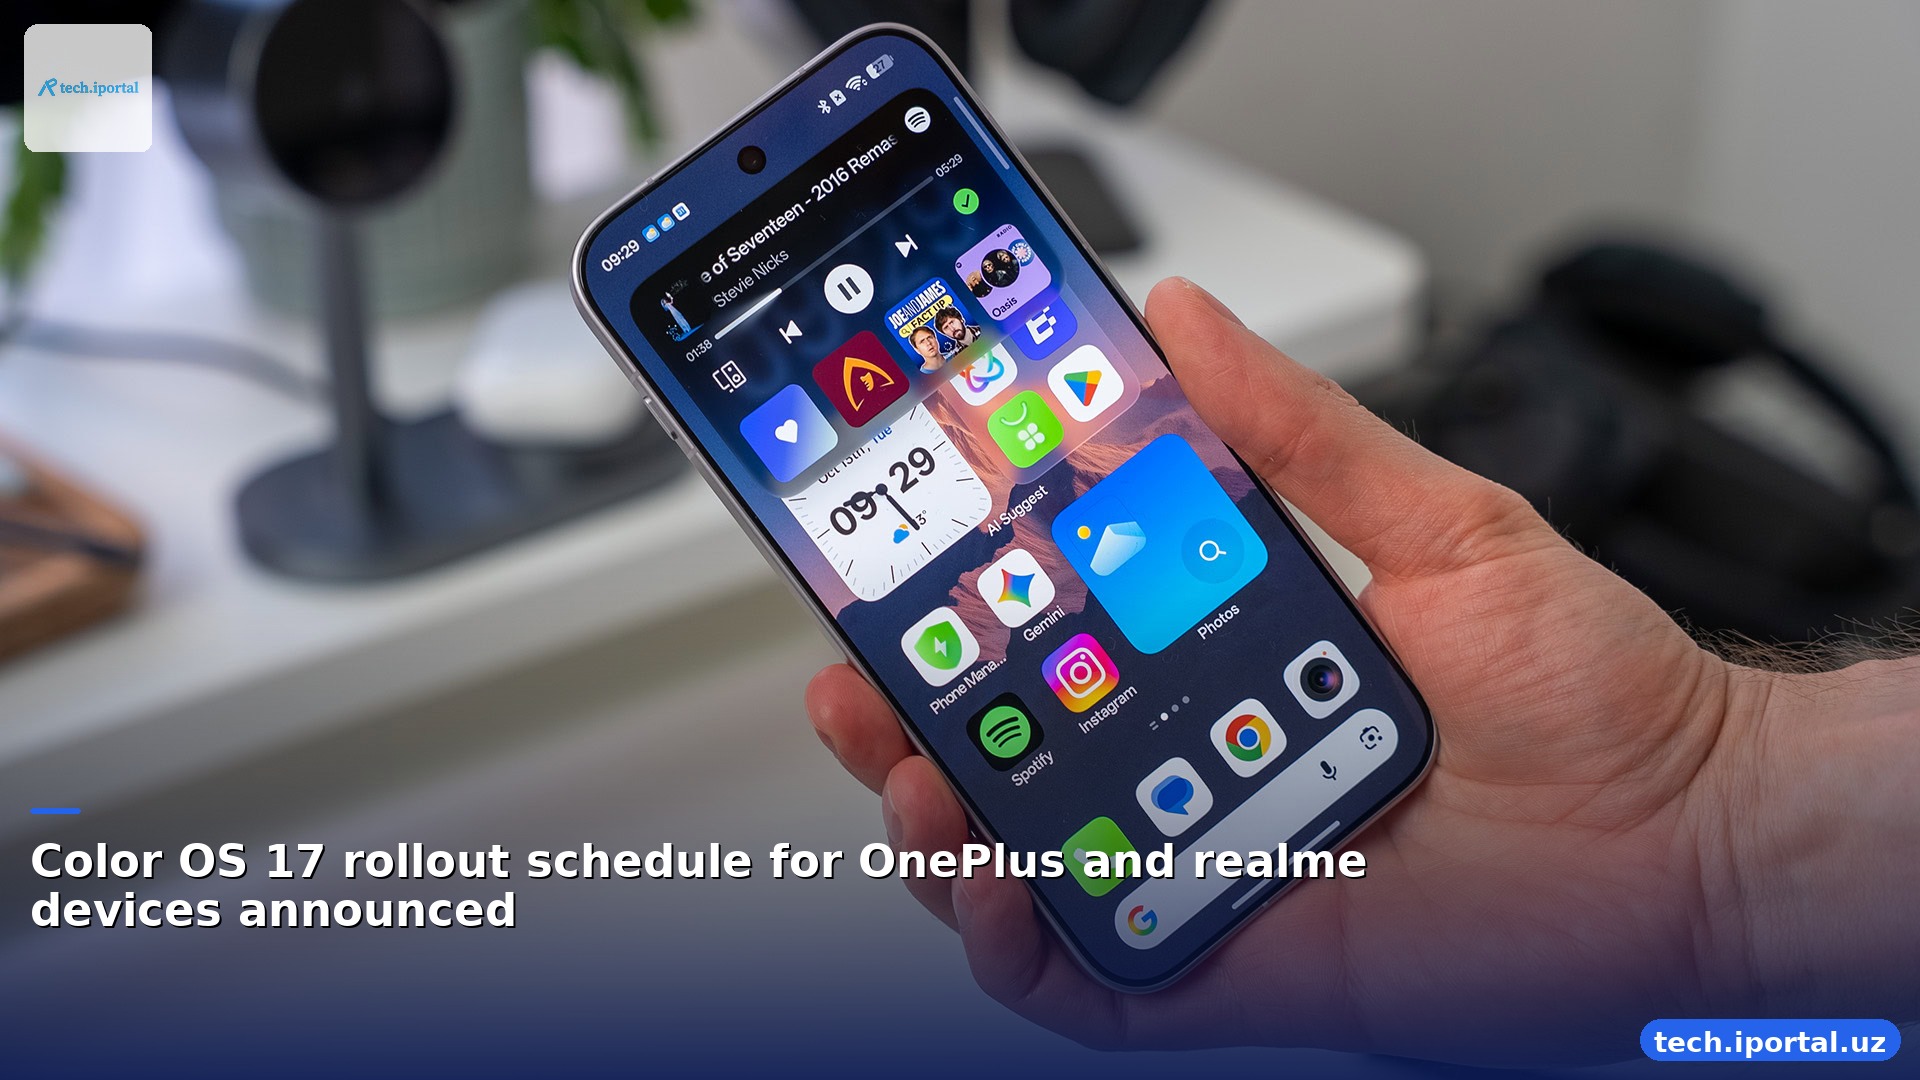
OnePlus and realme reveal official Color OS 17 rollout dates, starting Oct 29 2026 and extending into Q1 2027 for flagship and midrange models.
Software muhandislikni an'anaviy ko‘nikma kasblari bilan solishtirib, ularning mehnat tavsifi, AI tahdidi va kelajakdagi roli haqida chuqur tahlil.
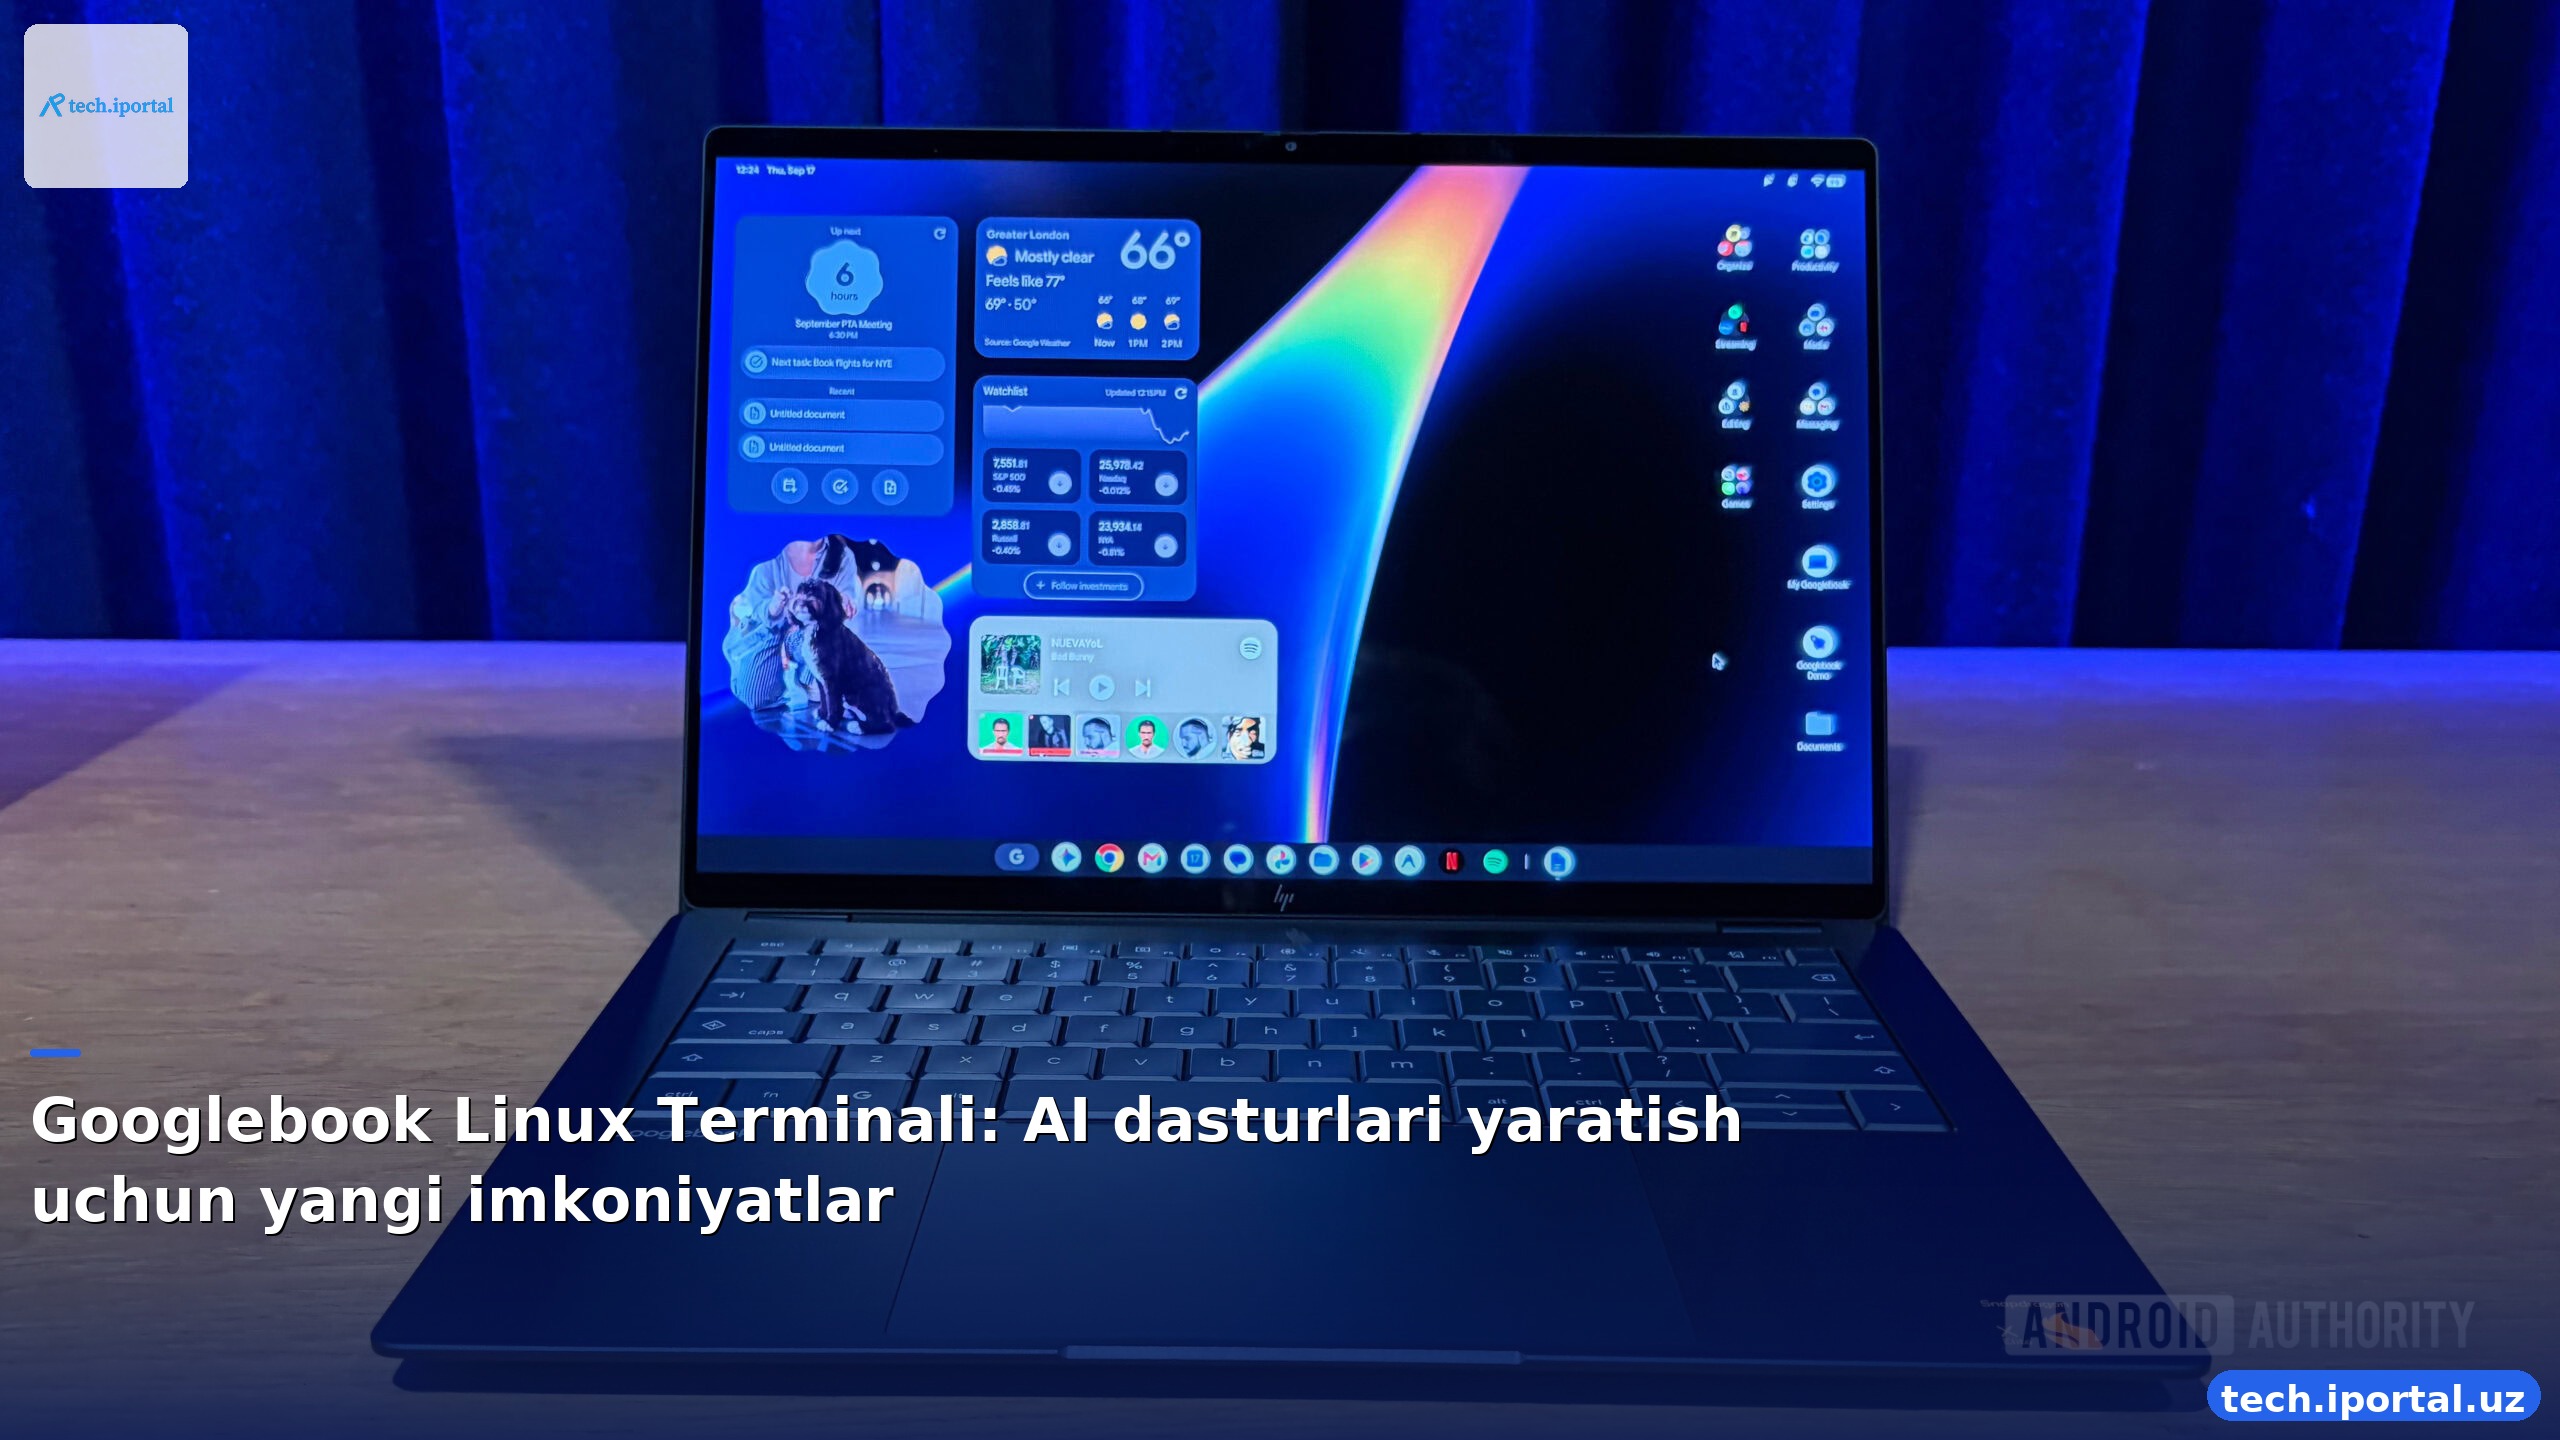
Googlebook uchun yangi Linux terminali e'lon qilindi, bu foydalanuvchilarni AI dasturlari yaratish, skriptlarni yozish va avtomatiklashtirish vazifalarini bajarish imkoniyatini beradi.
Google Gemini chat ilovasining yangilanishi bilan Spark vazifalari asosiy chatga integratsiya qilindi. Yangi dizayn "Chat" va "Vazifa" tugmalari, "Jadval" sahifasi va yangi filtrlash imkoniyatlarini taqdim etdi.