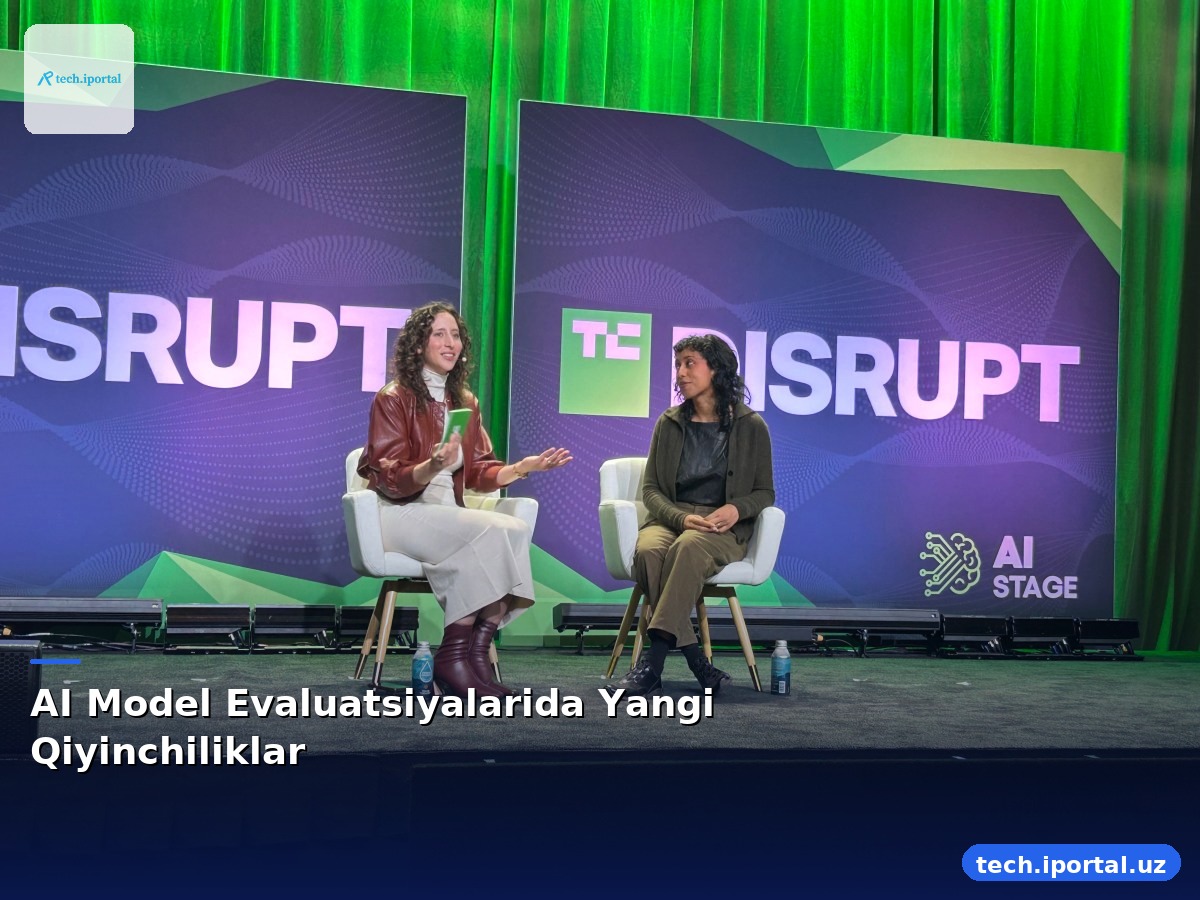
AI laboratoriyalari o'zining obro'larini model benchmarkingga bog'laydilar. Bu tizim, odatda, neytral va aniq deb hisoblangan evaluatsiyalar tizimi bo'lib, ularning maqsadi bir AI mahsuloti ikkinchisidan yaxshiroq ekanligini aniqlashdir. Biroq, bu evaluatsiyalar usullari murakkab va hali ham rivojlanmoqda, deb Irene Solaiman, Hugging Face boshqaruvchisi, TechCrunch Disrupt forumida aytdi.
Solaiman shunday dedi: "Agar biz bu evaluatsiyalarga kelajakda ishonishimiz kerak bo'lsa, ular bir xil ilmiy usullarga ega bo'lishi kerak." Ushbu so'roqni hisobga olgan holda, hozirgi evaluatsiyalarni ishonishimiz mumkinmi?
Ishonchli Evaluatsiyalar
"Ishonch" atamasi juda og'ir so'z, deb Solaiman aytdi. "Natijalarni ishonishimiz mumkinmi? Bu, birinchi navbatda, evaluatsiya natijalari takrorlanishini ta'minlash bilan bog'liq. Siz modelga yetarlicha kirish imkoniyatiga ega misiz? Bu yerda ochiq vaznlar katta rol o'ynaydi."
Model evaluatsiyalarida takrorlanish muammosi hali ham muhokama qilinayotgan muhim mavzularidan biridir. Biror bir testning haqiqiy bo'lishi bilan birga, u boshqa evaluatsiyalar bilan qanday taqqoslanadi, degan savol ham mavjud.
"Bu evaluatsiyalar hali ham rivojlanayotgan ilmiy sohaga ega. Biz ularni bir-biri bilan qanday ma'noli taqqoslashimiz mumkinligini bilmaymiz," dedi Solaiman.
"Ular tezda samarasiz bo'lib qoladi va bizga kerak bo'lgan ekosistemni hali ham yetarlicha rivojlantirmaganmiz. Endi embedded evaluatorlar ekosistemi uchun talab bor, lekin bu evaluatorlar qaysi vazifalarni bajarishlari kerakligi bo'yicha standartlashtirish talab qilinadi."
Embedded Evaluatorlar
Embedded evaluatorlar tushunchasi — bu AI tashkilotlariga "neytral" uchinchi tomon kuzatuvchilarni joylashtirish. Bu tushuncha so'nggi oylarda mashhur bo'lib, AI laboratoriyalari xavfsizlik bilan bog'liq bir qator hodisalarga duch kelganidan keyin paydo bo'lgan. Hugging Face ham shunday bir hodisaning ob'ekti bo'lgan.
AI laboratoriyalari model xavfsizligi bilan bog'liq muammolarni aniqlash va kamaytirish uchun faol hukumat tartib-qoidalarini talab qilish o'rniga, uchinchi tomon erishuvlariga umid qilib, bu erishuvlarning neytralligi va samaradorligi haqida shubhalar qolmoqda.
Anthropic Accenture kompaniyasini birinchi evaluator sifatida yollaganidan keyin bir qator tanqidlarga duch keldi, ba'zilar esa bu konsalting firmasi bu vazifani bajarish uchun yetarlicha malakaga ega ekanligini shubha qildilar.
Evaluatsiyalarning Yangi Yonalishlari
Evaluatsiyalar hozirgi kunda modelning o'zini tekshirishdan model atrofidagi butun tizimni tekshirishga o'tmoqda. Bu tizimga modelga kirish uchun foydalaniladigan vosita ham kiradi. Solaiman shunday dedi: "Agentik evaluatsiyalar juda qiyin va juda qimmat. Bizda model uchun ko'proq evaluatsiyalar bor, lekin vosita uchun kam evaluatsiyalar bor. Biz holistik agent uchun yaxshiroq evaluatsiyalarni rivojlantirmoqdamiz, chunki bu ko'p odamlar uchun qimmatli."
Boshqacha qilib aytganda, evaluatsiya sohasi hozircha hali ham tartibsizlikda. Agar benchmarking biznes yetakchilari uchun foydali vosita bo'lib qolmoqda bo'lsa, barcha tomonlar bir xil tushunishga ega bo'lgan, bir xil, sanoat bo'yicha yondashuv talab qilinadi.